人都说 30 而立,40 知天命。以前也懂,但毕竟不如亲自体验来的真实。这不,在快要进入“知天命”的路上,这种感觉愈发的真实。根据平时网上看到的一些文字,我知道,这种体会和感受应该是普遍的。
RL究竟能不能突破Base边界——关于推理能力外推、稳定性与训练条件的系统分析
在 DeepSeek R1 之后,GRPO 几乎成了后训练的默认选项。它确实“好用”——在很多任务上,模型的 pass@1 明显提高了。但一个更根本的问题始终没有被真正回答:我们是在把模型“教得更会想”,还是只是在把它“已有的正确想法更容易采出来”?
如果答案只是后者,那么强化学习更像是一种采样精炼器;而如果答案是前者,那就意味着模型的推理能力可以被系统性地“向外推”。
这两种理解对应着不同的训练目标,也自然导向了不同的训练策略。与之相关的研究结论之所以看似分化,往往源于训练设定与任务分布的差异:在某些工作中,RL 被观察到伴随能力跃迁;而在另一些设定下,其作用则始终未超出 Base 模型的能力边界。
本文并不试图在“RL 是否能够突破 Base”这一争论中选边站队,而是系统梳理已有工作的结论与假设,试图澄清一个更关键的问题:
在什么条件下,RL 才可能表现为能力外推?而在什么情况下,它更合理地被理解为一种采样与抛光机制?
所爱隔山海,山海亦可平
前段时间空闲时间偶尔会想一个问题:“当历史的积累超越了人类学习的极限时会发生什么?”
其实不说以后,就现在已然出现知识爆炸的情况,研究方向越来越细,都不是“隔行如何山”了,稍微跨个方向可能都相差极大。是不是可以认为已经差不多到了“穷尽一生也学不完某个方向”的地步?
庄子曾说:“吾生也有涯,而知也无涯。以有涯随无涯,殆矣”。学无止境,古希腊哲学家芝诺也曾讲过一个“知识圆圈说”的故事。大概意思是,一个人的知识就好像一个圆圈,知识越多,圆圈越大,接触到的未知也越大。通俗来说就是:“知道的越多,不知道的越多”。
大哲学家尚且如此,我们普通人,怎么说呢,就是你越是热爱学习,越是努力学习,越发现知识的深不可测,以及自己的无知。我将之称为“知识黑洞”——当我们对一个方向钻研深入时,就好像误入黑洞——渺小、无助、但被吸引。
我是一名 AI 工程师,说到AI领域,那更是黑洞中的黑洞。文本、图像、视频、音频等不同模态算法,大模型、多模态、强化学习、推理部署等不同方向,这些还不算细分风向,比如大模型下的预训练、文本下的搜索、推理部署下的量化等等。另外,AI还属于计算机的分支,作为工程师你不能不懂编程、数据结构、计算机原理、网络、数据库等等。虽然很多方面可能并不需要掌握精深,但学习探索的时候也很容易扎下去,学到恍惚、迷惘。我时常会有这种无力感,不光是因为知识的无限,更是因为——我已经无法再像过去那样,相信“只要足够努力,就能覆盖足够多的世界”。很多时候我都会自问:努力之后呢?努力到什么时候呢?
面对这种情况,大概只有两种选择:不学和去学。
不学,很简单——维持现状,在现有位置上躺着即可。这种选择其实不见得不好。年轻的时候总觉得人就是得干出一番事业来,随着年纪的增长,逐渐认识到,平凡也是一种生活方式。幸福如人饮水,冷暖自知。很多时候“我”觉得人应该怎样其实只是“我”自己的观点,万不能强加到他人头上。
那去学呢?这就要考虑学什么、怎么学的问题。诚然,我们可以漫无目的地去学,这本身也是一种学习方式。但显然我们更看重有选择地去学,倒不一定有目的。这关键是机会成本,随着年纪增长,时间和精力越来越成为我们最宝贵的资源,我们当然希望能更有效力利用这些资源。这里的“有效”其实隐含了一个假设:我们需要有一个主线,说是理想也好、长期目标也罢,它的作用就是防止我们随波逐流,被这日益浮躁的社会冲跑。长期以往,即便速度慢,整体效率也不会低。在我看来,这个主线简单来说就是“所爱”——你所热爱的、挚爱的、永远为之着迷、为之充满热情的事物。找到它,一点一滴构建属于自己的体系,一砖一瓦筑造属于自己的框架。
“路虽远,行则将至”,心有所属,“不断前进,不断走向下一个目标”便是自然之事。这趟旅途可能永无终点,旅途路上可能日渐孤单,但我相信,“心之所向,身之所往”——“永远在路上”就是最好的修行。我不知道这样做是否能够获得世俗意义的成功,但它一定会让我们的心更加平静、祥和,这难道不也是一种成功?也许,人生本就没有所谓完美和圆满吧?
Reward建模新范式:无验证RL——当模型只能相信自己,会发生什么?
随着 GRPO 在后训练的不断应用和成熟,越来越多的任务都开始采用 RL 作为进一步提升效果的方案。但是对于那些缺乏明确标准答案的场景,除了人工标注外,还有没有其他比较高效、低成本的方案呢?
R1 之后出现了一种比较激进的方案:无验证 RL,模型不再依赖外部验证器,而是仅利用自身内部信号,如一致性、置信度或分布特征等来构造学习信号。
从最早的多数投票(TTRL、SRT),到基于熵与自确定性的强化学习,再到引入语义多样性与进化机制的最新方法,这个方向看似在不断取得进展,但其实这一类方法有个很严重的问题:“绝大多数内部反馈机制,本质上都在推动策略熵持续下降。”
这既解释了它们在训练初期或部分任务的有效性,同时也揭示了很多时候性能退化和探索崩塌的缘由。最新的工作从各个角度提出改进策略,如优势重塑、多样性奖励到进化式选择等等,但归根结底也都是在增加模型的探索能力,或者说平衡探索-利用。那么,对这种新的 RL 范式,你怎么看?
TL;DR
- TTRL / SRT、EM / RENT、Intuitor、EMPO 等方法都在显式或隐式地最小化策略熵。
- 内部反馈奖励几乎必然导致策略熵单调下降,最终引发探索不足与性能退化。
- ETTRL 通过高熵 token 分支 rollout 与基于熵的 advantage 重塑,缓解早期过度自信。
- Darling 将语义多样性显式并入奖励,增加探索。
- EVOL-RL 以“多数选择 + 新颖性变异”模拟进化过程,在稳定与探索之间取得更优平衡。
- RESTRAIN 利用全部 rollout 信号,对低一致性与过度自信样本进行系统性惩罚。
| 方案 | 具体做法 | 特点 |
|---|---|---|
| TTRL 250422[1] / SRT 250527[2] | 多数投票答案 | 部分领域(数学)使用 |
| EM 250521[3] FT | 直接最小化 token 级别熵(类似 SFT) | 数学和编码任务中强 |
| EM 250521[3] RL / RENT 250528[4] | 熵作为奖励 | 能在大型数据集上收敛 |
| EM 250521[3] INF | 将 LLM 输出的 logits 视为可自由优化的参数 | 最小化输出分布的熵 |
| EMPO 250408[5] | 将输出按语义聚类,语义簇熵作为奖励 | 增加一点多样性 |
| Intuitor 250526[6] | 自确定性(输出分布与均匀分布的平均 KL 散度)作为奖励 | 对“更长文本偏好”偏差不敏感 |
| ETTRL 250815[7] | 树状分支 rollout + Advantage clip | 降低成本、缓解早期估计偏差 |
| Darling 250902[8] | 奖励×多样性 | 增加回复的语义多样性 |
| EVOL-RL 250918[9] | 模拟生物进化增加新颖性奖励 | 防止熵崩塌 |
| RESTRAIN 251002[10] | 惩罚低一致性样本同时保留高潜力推理链 | 无监督自我改进 |
DeepSeekV3.2后训练:稳定压倒一切
DeepSeek-V3.2 发布后,外界讨论大多集中在“新增了工具使用”、“是不是比某某更强”之类的话题。但如果你真正关心模型训练,会发现它最值得研究的地方根本不在模型能力,而是在 后训练(post-training)阶段的一系列稳定性工程。V3.2 不像 V3 带来结构性突破,更像是一次“工程师版本的 V3.2”:没什么光鲜亮丽的大新闻,但每一个小改动都在解决真实训练痛点。
TL;DR
DeepSeek-V3.2 的后训练重点不是“更强”,而是“更稳”。大量技巧围绕 GRPO 稳定性 展开。
- 数据部分:多个领域专用专家 → 生成数据 → 蒸馏到统一模型。
- GRPO 稳定性优化:
- Advantage 去标准差:消除难度偏差,提高样本权重的公平性。
- KL 的无偏修正:基于 K3 + 重要性采样,使 KL 梯度更稳定可靠。
- 序列级 off-policy 掩码:屏蔽高偏差且优势为负的序列,显著提升稳定性。
- MoE 路由保持:固定专家路由,避免 off-policy 和训推框架不同导致的路由漂移。
- 采样保持:保持
π_old与π_θ的动作空间一致,避免采样截断可能带来的稳定性问题。
- 工具使用部分提出更高效的思维轨迹管理方式:只有新用户消息进来才清空工具调用推理轨迹,工具调用历史则始终保留。
DeepSeekMath-V2自我验证:搞数据的风吹到了奖励模型
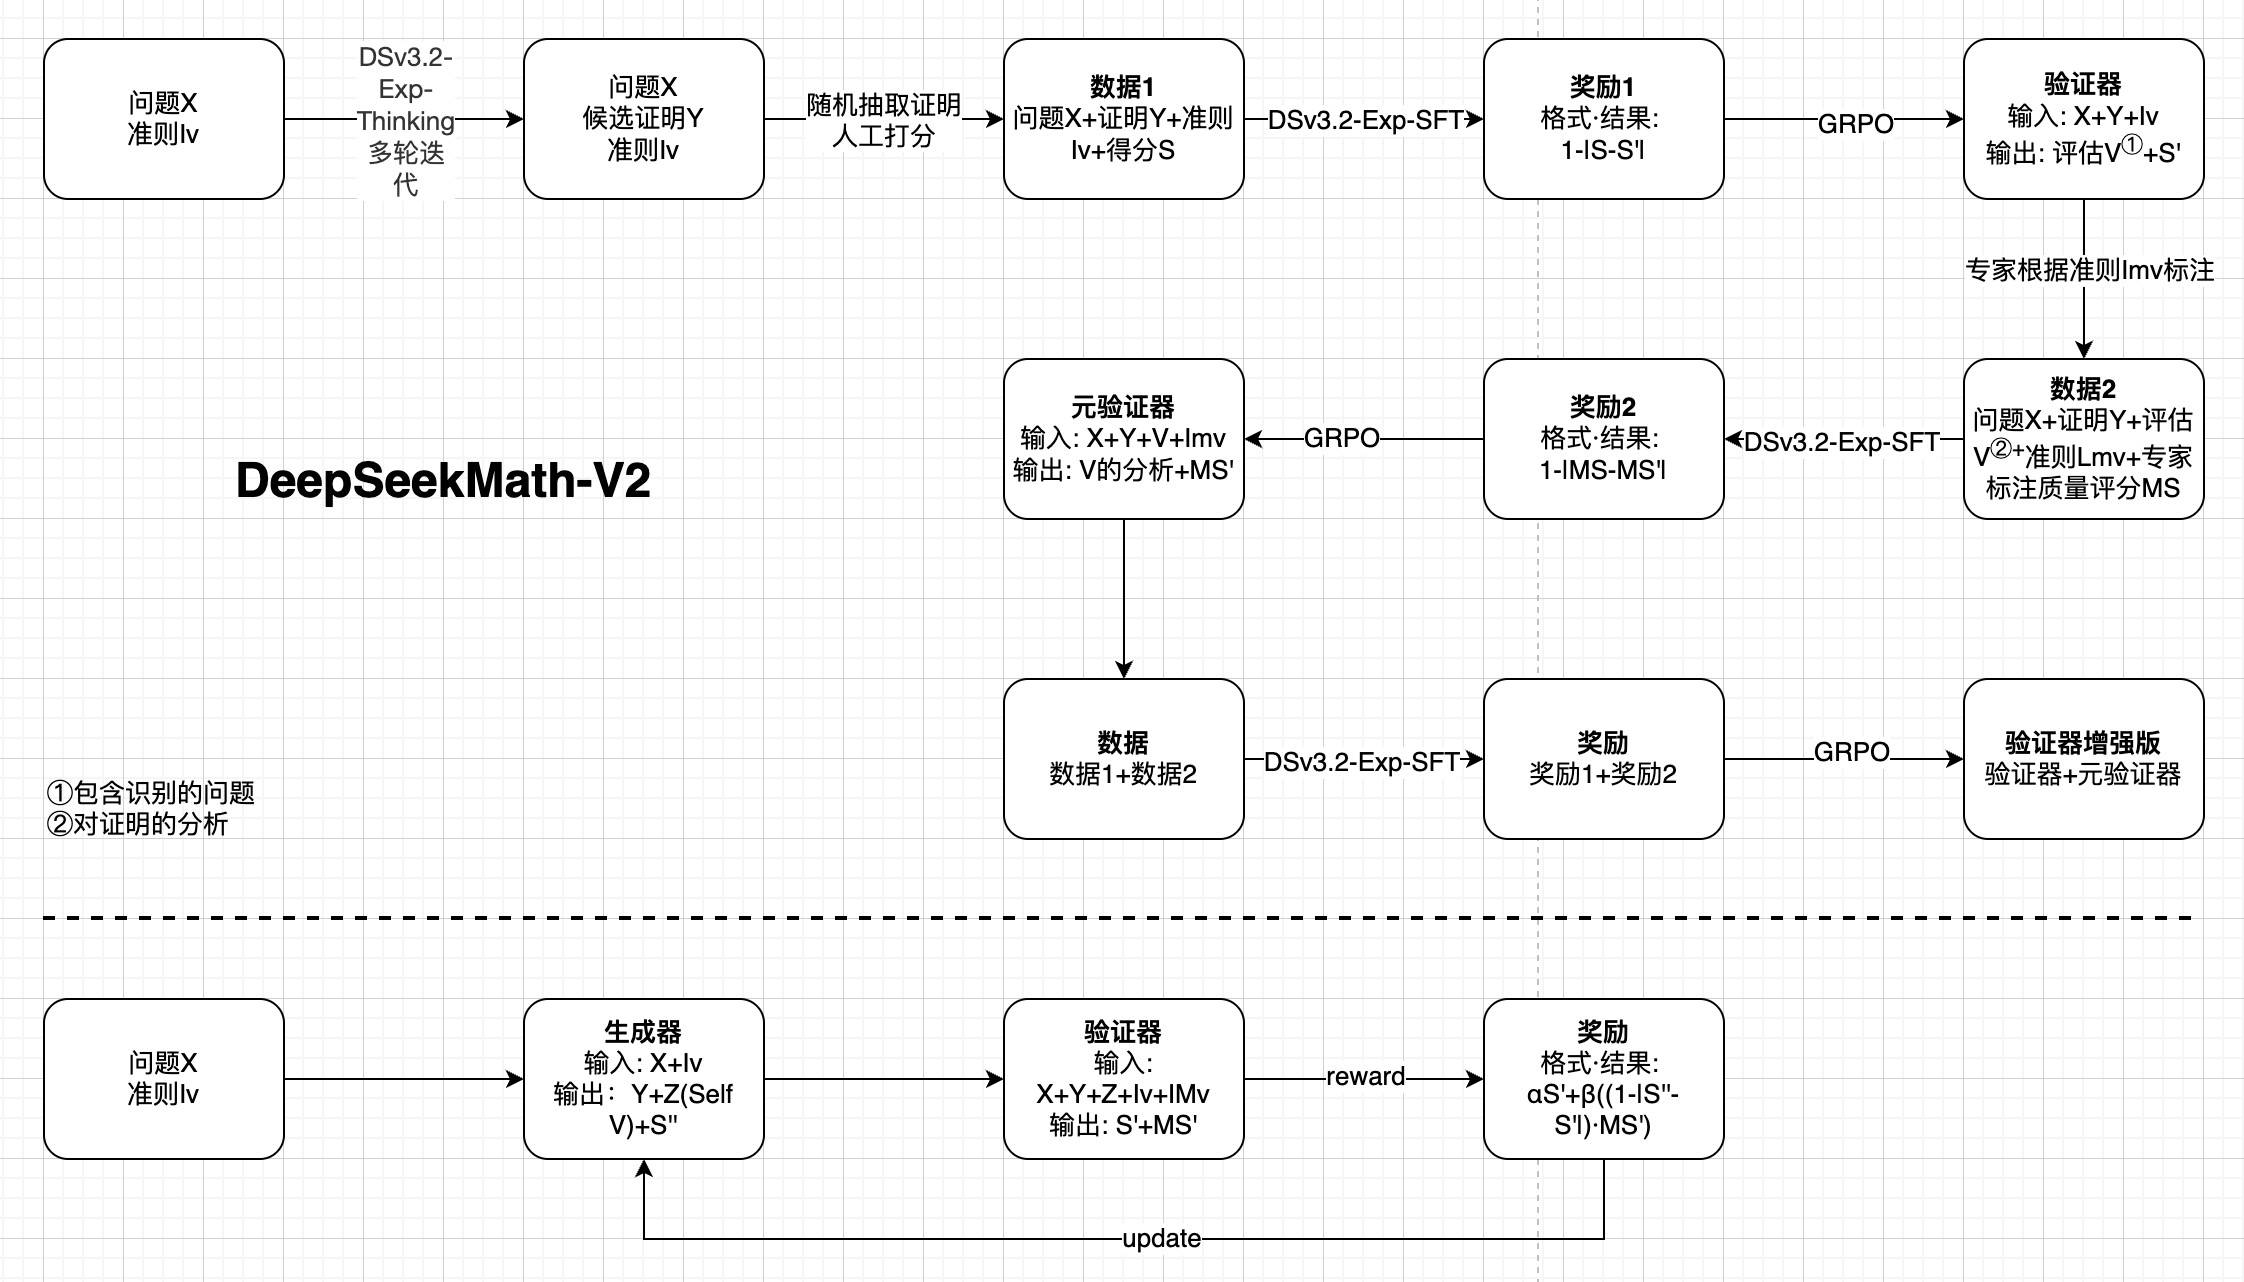
在开放性问题上,仅靠生成答案很容易出错。如何让模型不仅能写出证明,还能识别自身错误,从而形成闭环优化?答案是——自我验证。来看一下 DeepSeek 最新的论文:DeepSeekMath-V2: Towards Self-Verifiable Mathematical Reasoning[1],看自我验证如何让 LLM 生成与评估协同来提升数学定理证明能力。
TL; DR
- 训练验证器:验证器不仅打分,还识别证明中的问题。
- 引入元验证:通过二次评分机制防止验证器虚构问题,使验证分析更可靠。
- 训练生成器:生成器在生成证明后进行自我分析,并根据验证器和元验证器的反馈优化输出。
- 验证生成协同:生成器与验证器形成闭环,生成新的证明挑战验证器能力,同时扩大自动标注数据,提高整体系统可靠性。
核心启示是:奖励模型不仅要给分数,更要建模评估分析过程,让生成与验证形成协同闭环,显著提升开放性问题的推理能力。
两处容易踩的坑:LLM 消息数组与字典工具的隐藏副作用
在 LLM 应用开发里,我们经常需要处理多轮消息、对话历史等结构化内容。理论上,这些对象应该是简单、透明、可控的——但在 NumPy 和特定字典工具(如 addict.Dict)参与后,一些微妙的行为会悄悄改变数据结构,让输出变得诡异甚至完全不对。本篇记录我在实际开发(尤其是 verl 与 transformers)中遇到的两个“小问题”:一个来自 NumPy 的自动维度推断,另一个来自字典工具的默认属性行为。它们不是 bug,却可能让你花一阵子 debug。
TL;DR
- NumPy 变长消息问题:当使用
np.array(..., dtype=object)处理长度不一致的消息列表时,NumPy 可能返回不同维度的数组,导致后续处理出错。改用np.fromiter或预分配 object 数组并赋值,可确保输出结构统一。 - 字典赋值工具干扰问题:使用
addict.Dict等动态字典工具包装消息数据时,其默认行为会干扰 transformers 对消息结构的正确判断,导致模板生成错误。可换用OmegaConf或修改addict源码禁用自动建键功能以修复问题。
Hybrid LLM 之 Gated DeltaNet
Qwen3-Next 采用了混合架构让人眼前一亮,其中重要的 Gated DeltaNet 模块设计优雅,最大限度地在工程效率和模型效果之间探索平衡,值得学习了解。
TL; DR
- DeltaNet:线性 attention 可以看作矩阵状态的累积记忆,DeltaNet 通过 delta rule 更加精确地更新 KV 关联,缓解传统线性 attention 记忆过载问题。
- Gated DeltaNet:引入 α 门控,实现选择性遗忘与灵活记忆管理,提高检索精度和稳定性。
Reward建模新范式:无验证器RL与Reference的妙用
R1 之后,GRPO 等强化学习框架的成功让我们相信“反馈”是提升推理力的关键。
然而,当任务无法被规则验证时,这一框架就不太好用了。
本文介绍一种“无验证器”新范式,让模型用 Reference 自我强化,重新定义奖励建模。
TL;DR
- 传统 RLHF 依赖验证器或 RM 打分,但很多开放任务无法简单验证。
- NOVER: 基于 PPL 设计奖励,引入策略代理同步与效率奖励,稳定训练。
- Reinforcing General Reasoning: 直接最大化参考答案概率,以“正确答案的似然”替代验证器。方差更低,与 RLOO、PPO 等技术兼容。
- 逆向激励: 先生成答案,再生成自评得分,无需标准答案。适合创意、写作等难以客观评判的任务。
- Reference 进一步妙用: 帮助模型思考“为什么这是答案”,可用于生成高质量数据。也可与逆向激励结合。
子非我,安知我不知鱼之乐——AI、人类与意识的边界
TL;DR
- AGI已近在眼前:当前的大模型已在多个领域展现出专家能力,其发展因巨大的战略价值(如“知识霸权”)而不可阻挡。尽管Scaling Law遇到瓶颈,但通往AGI的路径依然多样且充满探索。
- AI可能是“新物种”,而非“类人”:AI在高级认知上媲美甚至超过人类,但其底层驱动力很可能与人类截然不同。人类的核心目标是基因决定的“更好地活着”,而AI很可能没有这种源于脆弱生命的生存本能。
- 人类的本能与情感是特质而非缺陷:人类的脆弱、情感和欲望,构成了我们鲜活的体验,是“人性”的宝贵部分。绝对理性、无欲无求的“神化”方向并不可取。
- 意识与自我认知的谜题:意识的本质或许与“自我认知”密切相关,但 AI 是否需要或会产生这样的“自我”,仍是未知数。
- 我们为何担忧AI:人类希望AI是“人工”智能,本质上是希望“奴役”一个强大的同类,这种控制欲与历史上对权力的追求一脉相承。但当这个“同类”的本质与我们完全不同,同时还比我们强大很多时,担忧便油然而生。