OmniDreams:实时世界模型背后的 Self Forcing 与 DMD

大模型出来后一直在做这方面的后训练,从业务魔改到训练框架都做过,今年开始尝试设计新的算法,冲一冲 sota。大型的已经三次了,每次野心都很大,不过都没有特别成功。第一次是统一可验证/不可验证方向 GRPO,结果 sota 没有扩到更大 Size 模型;第二次是想一次解决 dense reward 的问题,还是差点意思;第三次是统一整个后训练(SFT、DPO、GRPO、OPD 等等)框架,目前看效果还没有特别明显。

后训练的论文看的有点多(感兴趣的朋友可以通过这个项目[1]了解),有时候忽然有种不想看的感觉,来来回回就是那些做法,GRPO 火了,就猛改,整个链路每个点都被薅干;OPD 火了,GRPO 的方法拿过来再撸一遍。看多了,真有种看山还是山的感觉,有时候觉得索然无味。但是自己偏偏又没法稳定 sota,而且在这种红海里,其实能研究的点本身就很挤(换个方向就好很多)。

于是就想换换脑子,恰好一直对 Embodied 感兴趣,之前其实已经写过一篇《VLA Sim-Real 协同训练 | 长琴[2]》了,那就继续这个方向吧,正好世界模型现在如火如荼,就读点这方面的工作看看。再者说,后训练为啥要区分模态呢?模态之间说不定还能彼此借鉴呢。

再说点题外话,很多人可能在想,现在 AI 都这么强了,还有必要看 paper 吗,AI 直接整理出来不香吗?的确如此,绝大多数论文(保守估计 95%)不需要认真读,现在水文在 AI 的助长下更多了,每篇都看就是浪费生命。但是一些好论文还是值得仔细研读的,这里的读其实是让脉络在我们自己脑海里展开、联结,形成新的认知。

我一直觉得认知改变最重要,远比学会某个算法或技巧更重要,咱们《技术与人》公众号的简介里就写着“技术改善世界,认知重塑思维”。在现在这个时代,更是如此,代码、复现、笔记,甚至解读其实都非常廉价,AI 能做的更好,真正有价值的是认知有没有被影响,知识点有没有 connect 起来,涌现出新的认知。你的输出要么是单点极限突破,要么是多点联合抽象(本站这个方向较多),这两个角度都是带有自身大量的 context,AI 几乎没法替代。尤其是多点联合,AI 即便知道你的 topic,也不可能写出和你一模一样的内容,甚至你们选的 paper 列表都大不相同。
More →

想做,但可以不做:AI 时代的注意力与自由

上篇文章拖了将近一个月才写完,固然有十一假期的缘故(众所周知,有娃的假期比上班还忙还累),但最近的状态已经有点失控的边缘了,我自己认知上感受到了这一点,但调整起来着实费劲,本文就聊一下这个,以及自己的一些心得。

状态有点失控的原因有三个:

  • AI 加持下不间断的工作,除了睡觉带娃,其他时间都是看着工作的。大量的项目并发,几十个 codex/claude 窗口。
  • 短视频,尤其 AI 短剧的干扰,虽然不至于沉迷,但多少还是刷了几部。
  • 快节奏下注意力变得比之前难以集中,尤其是难以沉下心来深读 paper,或长篇幅文献。好不容易建立起来的只看英文的习惯,正在被各种翻译插件打烂。

从慢慢察觉到有些失控,到现在开始尝试控制,前前后后加起来怎么也得两三个月了。如今的我依然在积极调整中,取得了一点点小小的成果,但离自己期望的理想状态还有差距。本文就记录一下这方面的一点感受吧。

More →

OPD-RL 新范式:diff 出圈——从目标,到奖励,再到梯度

OPD 大家熟知是需要一个 teacher 提供 logits 的,OPSD(自蒸馏)一般是拿一个外部信号让模型自己提升,都是现在的主流范式。我们前阵子介绍的《「差值即信号」:OPD 蒸馏的新范式 | 长琴[1]》在 OPD 这个方向上更进一步——不是直接学教师,而是学教师在不同情况下的「差异」,类似于学这种「能力」。我们把这种差值简称为 diff。

Diff 出现后,一个很自然的问题就来了——teacher 不一定再需要一个更大更强的模型,只要能提供 diff 那就是 teacher。这就是前文提到的 W2S(weak to strong)OPD,weak 模型便宜好训,可以训练一大堆不同方向的,然后 diff 一股脑儿给 student。

但是这里怎么给还是有蛮多做法的,这就引出了现在大家正在看的这篇文章。

More →

从Pass@k到advantage,一场意想不到的邂逅

谈到 GRPO,我们不由自主会想到它的“抛光”特点——在 Base 的基础上做进一步锐化,我们之前在不少文章中都提到过,比如《RL究竟能不能突破Base边界——关于推理能力外推、稳定性与训练条件的系统分析 | 长琴[1]》。为了保持模型的探索性,常见的基本做法就是控制熵,这个方向有一大堆论文研究,我们也写过一点,比如《GRPO“第一背锅侠”Token Level X2:GTPO双“T”傍地走 | 长琴[2]》、《GRPO优化在继续——CISPO和熵 | 长琴[3]》。

今天介绍一个新的思路和方向,比训练中控制更前一步,直接优化 Pass@k,而不是 Pass@1——《2508 Pass@k Training for Adaptively Balancing Exploration and Exploitation of Large Reasoning Models[4]》,来自字节 seed × 人大。至于为什么会突然关注到这个方向,那自然是工作中遇到需要保持多样性的优化问题了。发现这个新方向后感觉还挺有意思,就拿来了解一下。

More →

Reward 设计的本质:从 hack 到 hard

上次在讨论《从持续学习到下一代 AI 方向探讨 | 长琴[1]》时,我们说到 reward、评价系统,今天就来聊聊这个话题。Reward 对 RL 至关重要,或者说 RL 的目标其实就是 reward。无论是之前的 RL,现在的 RL,还是未来的 RL,都离不开 reward 的设计,可是关于 reward 本身的思考方面的研究却并不多见。本文就通过几篇相关的研究来和大家共同探讨一下。

More →

「差值即信号」:OPD 蒸馏的新范式

随着 OPD 不断成熟,现在的做法早已不再是简单的 teacher 蒸馏了,最近看了几篇相关文章,发现一个研究范式转移:从「怎么蒸馏(温度/KL方向/采样策略)」到「蒸馏什么(信号分解与归因)」。具体做法可以用一个简单公式说明:

1
有效信号 = f(output_A) − f(output_B)

A、B 在恰好关心的那一维度不同,其余对齐。这个本质是反事实对比在 token-level 蒸馏上的应用——不学习教师原始输出,而是学习「教师在特定条件变化下的输出差」。简单来说,不是直接学教师,而是学教师在不同情况下的「差异」,类似于学这种「能力」。本文我们就看看它们都是怎么做的,以及会给我们什么启发。

More →

从持续学习到下一代 AI 方向探讨

前几天梁文锋(后面用梁佬代替)的演讲稿有点出圈,我也去看了一下,看了两个版本,一个是录音文字稿(知乎已经被删掉了),一个是 52 条摘要整理稿[1]。看完后有一些启发,尤其是关于下一代大模型的,这个其实自从 2017 年转行做 AI 到现在,一直没有停止过思考,所以本文重点从持续学习角度探讨这个方向。

More →

SIS:不硬clip,大部分token其实可转为on-policy

关于重要性采样系数,之前已经介绍过不少了,不过主要方案还是 clip,比如《GRPO“又一背锅侠”:Clip的各种拉扯 | 长琴[1]》中介绍的一系列文章,更进一步的优化是《GRPO优化在继续——CISPO和熵 | 长琴[2]》的 sg 和 特定 token mask,Minimax 后续模型也都用了自家的 CISPO,但是依然没有脱离 clip 和超参数设置。

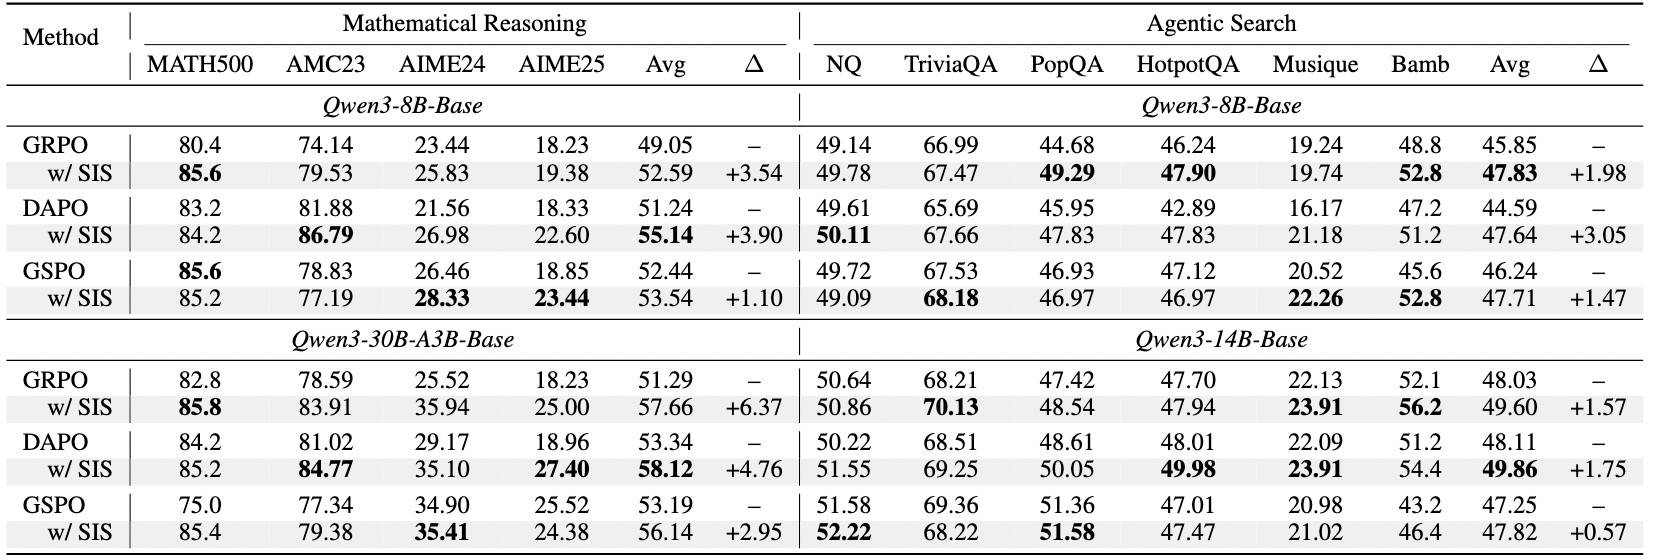
Clip 有助于训练稳定,这没问题,但它最大的问题是会抑制来自高偏差策略样本的梯度,从而丢失有价值的学习信号。本文我们介绍的 SIS(Selective Importance Sampling)来自论文 Turning Off-Policy Tokens On-Policy: A Plug-in Approach for Improving LLM Alignment (arxiv:2607.04728)[3](文章图片、公式均来自此论文),在这个方向上再进一步。他们的出发点很简单——将那些 off-policy 的 token 转为 on-policy,自然就不需要 IS 了。具体怎么做的呢?他们将旧策略作为建议分布,执行 token 级别的拒绝测试:被接受的 token 自然就可以看作 on-policy 的,被拒绝的那就保持原来的 IS。

SIS 是即插即用的,仅修改重要性采样系数,而且它还有个正的外部性——提升训练的稳定性。关于稳定性我们在《GRPO“第一背锅侠”Token Level X:DAPO/DrGRPO与GSPO/GMPO的殊途同归 | 长琴[4]》提过,后面又专门写了两篇相关文章:《稳定压倒一切:MoE RL 训推不一致问题及解决策略 | 长琴[5]》、《MoE RL 训练不稳定性再思考:训推不一致,还是采样噪声? | 长琴[6]》,感兴趣的同学可以进一步阅读。

这里的问题或麻烦可能在于引入一个拒绝测试,不过论文给出了一个近似做法,使整个计算保持较低计算成本。效果和稳定性双全(见下表),值得一试。

More →