文章目录
27 节
TL;DR
TRPO 解决了强化学习中“策略更新步长难以确定”的痛点。它通过数学证明,将复杂的策略改进过程转化为一个带约束的局部优化问题。
核心思想 :利用 KL 散度在“概率分布空间”而非“参数数值空间”衡量更新距离。三大支柱 :MM 保证单调提升、信任区域 (Trust Region)确保更新稳定、共轭梯度 (CG)实现高维参数的高效求解。历史地位 :它是 PPO 和 GRPO 的理论基石,定义了现代 RL 对齐算法的底层逻辑。
一直想仔细读一下 TRPO 的 paper [1] ,每次都拖延住,这次是真的不得不上了,趁热打铁,记录一下。顺便说一句,类似 TRPO 这种 paper 是我个人非常喜欢的一类文章,写的很好,非常推荐。
TRPO 这篇论文在现代强化学习中的地位不亚于 “Attention is all you need” 在 LLM 中的地位,后续大放异彩的 PPO、GRPO 其实都是在给 TRPO 的基础上“做减法”。
比如 PPO,TRPO 计算 Fisher 矩阵和共轭梯度实现极其复杂,PPO-Clip 直接用截断把新旧策略的比值强行限制在 [ 1 − ϵ , 1 + ϵ ] [1-\epsilon, 1+\epsilon] [ 1 − ϵ , 1 + ϵ ]
总的来说,只要符合以下三点的,基本都是 TRPO 这一脉的:
重要性采样:用旧数据训练新模型,必须修正分布偏差,分子分母的比例永远是核心。
信任区域 :步子不能太大,必须限制在一定范围内,否则策略直接崩溃。
优势函数:不考虑绝对得分,只看当前动作是否比平均水平更好。
好了,我们开始吧。大多数策略优化算法可以归为三大类:
策略迭代方法:在当前策略下估计价值函数,并据此改进策略,两者交替进行。关键是价值函数,利用价值函数先评估当前策略好不好,然后根据 value 来调整策略。比如 RLHF,更经典的 Q-Learning、Actor-Critic 等。
策略梯度方法:利用从采样轨迹中获得的期望回报(总奖励)梯度的估计来更新策略。不学 value,直接看哪些动作带来高 reward,就把这些动作的概率调高,属于直接改策略,我们熟悉的 PPO、GRPO 在这里。
无导数优化方法:如交叉熵方法、协方差矩阵自适应,这类方法将回报视为关于策略参数的黑箱函数进行优化。不管梯度,随机采样参数看看哪个 reward 高就往那边靠,类似进化或遗传算法。
背景知识
从理论上看,基于梯度的优化算法在样本复杂度上更优(更少的数据达到同样效果);从实践来看,监督学习中梯度方法已经被证明可以高效训练大规模模型。但在强化学习的不少任务上,尚未稳定战胜“无梯度”的随机搜索方法。本文就是针对这点,证明了:最小化某个特定的替代目标函数可以在非平凡步长 (在保证策略变好的前提下,每一步更新是“有实际推进效果”的,而不是趋近于 0 的微小调整)下保证策略改进。据此,经过一系列近似后得出一个可用的算法:TRPO——具有良好可扩展性、能够优化包含数万参数的非线性策略。
基本定义
考虑一个无限时域的折扣马尔可夫决策过程,由六元组 ( S , A , P , r , ρ 0 , γ ) (S,A,P,r,ρ_0,γ) ( S , A , P , r , ρ 0 , γ )
S S S A A A P : S × A × S → R P : S \times A \times S \rightarrow \mathbb{R} P : S × A × S → R r : S → R r : S \rightarrow \mathbb{R} r : S → R ρ 0 : S → R \rho_0 : S \rightarrow \mathbb{R} ρ 0 : S → R s 0 s_0 s 0 γ ∈ ( 0 , 1 ) \gamma \in (0, 1) γ ∈ ( 0 , 1 )
π \pi π S × A → [ 0 , 1 ] S \times A \rightarrow [0, 1] S × A → [ 0 , 1 ] η ( π ) \eta(\pi) η ( π )
η ( π ) = E s 0 , a 0 , … [ ∑ t = 0 ∞ γ t r ( s t ) ] , where s 0 ∼ ρ 0 ( s 0 ) , a t ∼ π ( a t ∣ s t ) , s t + 1 ∼ P ( s t + 1 ∣ s t , a t ) . (1) \begin{aligned}
& \eta(\pi)=\mathbb{E}_{s_0, a_0, \ldots}\left[\sum_{t=0}^{\infty} \gamma^t r\left(s_t\right)\right], \text { where } \\
& s_0 \sim \rho_0\left(s_0\right), a_t \sim \pi\left(a_t \mid s_t\right), s_{t+1} \sim P\left(s_{t+1} \mid s_t, a_t\right) .
\end{aligned} \tag{1}
η ( π ) = E s 0 , a 0 , … [ t = 0 ∑ ∞ γ t r ( s t ) ] , where s 0 ∼ ρ 0 ( s 0 ) , a t ∼ π ( a t ∣ s t ) , s t + 1 ∼ P ( s t + 1 ∣ s t , a t ) . ( 1 )
Q V A 的定义如下:
Q π ( s t , a t ) = E s t + 1 , a t + 1 , … [ ∑ l = 0 ∞ γ l r ( s t + l ) ] V π ( s t ) = E a t , s t + 1 , … [ ∑ l = 0 ∞ γ l r ( s t + l ) ] A π ( s , a ) = Q π ( s , a ) − V π ( s ) , where a t ∼ π ( a t ∣ s t ) , s t + 1 ∼ P ( s t + 1 ∣ s t , a t ) for t ≥ 0 (2) \begin{aligned}
& Q_\pi\left(s_t, a_t\right)=\mathbb{E}_{s_{t+1}, a_{t+1}, \ldots}\left[\sum_{l=0}^{\infty} \gamma^l r\left(s_{t+l}\right)\right] \\
& V_\pi\left(s_t\right)=\mathbb{E}_{a_t, s_{t+1}, \ldots}\left[\sum_{l=0}^{\infty} \gamma^l r\left(s_{t+l}\right)\right] \\
& A_\pi(s, a)=Q_\pi(s, a)-V_\pi(s), \text { where } \\
& \quad a_t \sim \pi\left(a_t \mid s_t\right), s_{t+1} \sim P\left(s_{t+1} \mid s_t, a_t\right) \text { for } t \geq 0
\end{aligned} \tag{2}
Q π ( s t , a t ) = E s t + 1 , a t + 1 , … [ l = 0 ∑ ∞ γ l r ( s t + l ) ] V π ( s t ) = E a t , s t + 1 , … [ l = 0 ∑ ∞ γ l r ( s t + l ) ] A π ( s , a ) = Q π ( s , a ) − V π ( s ) , where a t ∼ π ( a t ∣ s t ) , s t + 1 ∼ P ( s t + 1 ∣ s t , a t ) for t ≥ 0 ( 2 )
这里的核心是优势函数 A,优化目标实际上是找一个新的策略 π ~ \tilde{\pi} π ~
Q 表示 ”在状态 s 采取特定动作 a “ 之后能拿多少分。
V 表示 ”在状态 s 按照当前策略期望水平“ 能拿多少分。注意公式里 a t a_t a t
A 表示 ”特定动作 a 是否比平均水平更好“。也就是说,动作 a 比正常基准好了多少。
有同学可能有疑惑,为啥要引入 V 呢,Q 不是能得到 a 的分数吗?这里主要是策略更新的稳定性考虑,如果只用 Q 更新策略会导致方差很大,减去 V 等价于将分数”归一化“,就是只看相对变化多少,这会让策略更新更加稳定。
实际工程中,也常常利用 TD 或 GAE 来近似 A(我们此前在《VAPO:基于价值方法的新突破 | 长琴 [2] 》等多篇文章都提到过),
A π ( s t , a t ) ≈ r t + γ V π ( s t + 1 ) − V π ( s t ) (3) A_{\pi}(s_t, a_t) \approx r_t + \gamma V_{\pi}(s_{t+1}) - V_{\pi}(s_t) \tag{3}
A π ( s t , a t ) ≈ r t + γ V π ( s t + 1 ) − V π ( s t ) ( 3 )
这时候只需要一个 V 网络即可推算出 Q(前两项)和 A。
策略提升原理
另一个策略 π ~ \tilde{\pi} π ~ π \pi π
η ( π ~ ) = η ( π ) + E s 0 , a 0 , ⋯ ∼ π ~ [ ∑ t = 0 ∞ γ t A π ( s t , a t ) ] (4) \eta(\tilde{\pi})=\eta(\pi)+\mathbb{E}_{s_0, a_0, \cdots \sim \tilde{\pi}}\left[\sum_{t=0}^{\infty} \gamma^t A_\pi\left(s_t, a_t\right)\right] \tag{4}
η ( π ~ ) = η ( π ) + E s 0 , a 0 , ⋯ ∼ π ~ [ t = 0 ∑ ∞ γ t A π ( s t , a t ) ] ( 4 )
令 ρ π \rho_\pi ρ π
ρ π ( s ) = P ( s 0 = s ) + γ P ( s 1 = s ) + γ 2 P ( s 2 = s ) + . . . (5) \rho_\pi(s) = P (s_0 = s)+\gamma P (s_1 = s)+ \gamma^2 P (s_2 = s)+... \tag{5}
ρ π ( s ) = P ( s 0 = s ) + γ P ( s 1 = s ) + γ 2 P ( s 2 = s ) + ... ( 5 )
ρ π ( s ) \rho_\pi(s) ρ π ( s )
η ( π ~ ) = η ( π ) + ∑ t = 0 ∞ ∑ s P ( s t = s ∣ π ~ ) ∑ a π ~ ( a ∣ s ) γ t A π ( s , a ) = η ( π ) + ∑ s ∑ t = 0 ∞ γ t P ( s t = s ∣ π ~ ) ∑ a π ~ ( a ∣ s ) A π ( s , a ) = η ( π ) + ∑ s ρ π ~ ( s ) ∑ a π ~ ( a ∣ s ) A π ( s , a ) (6) \begin{aligned}
\eta(\tilde{\pi}) & =\eta(\pi)+\sum_{t=0}^{\infty} \sum_s P\left(s_t=s \mid \tilde{\pi}\right) \sum_a \tilde{\pi}(a \mid s) \gamma^t A_\pi(s, a) \\
& =\eta(\pi)+\sum_s \sum_{t=0}^{\infty} \gamma^t P\left(s_t=s \mid \tilde{\pi}\right) \sum_a \tilde{\pi}(a \mid s) A_\pi(s, a) \\
& =\eta(\pi)+\sum_s \rho_{\tilde{\pi}}(s) \sum_a \tilde{\pi}(a \mid s) A_\pi(s, a)
\end{aligned} \tag{6}
η ( π ~ ) = η ( π ) + t = 0 ∑ ∞ s ∑ P ( s t = s ∣ π ~ ) a ∑ π ~ ( a ∣ s ) γ t A π ( s , a ) = η ( π ) + s ∑ t = 0 ∑ ∞ γ t P ( s t = s ∣ π ~ ) a ∑ π ~ ( a ∣ s ) A π ( s , a ) = η ( π ) + s ∑ ρ π ~ ( s ) a ∑ π ~ ( a ∣ s ) A π ( s , a ) ( 6 )
该式告诉我们,新策略 π ~ \tilde{\pi} π ~ η ( π ~ ) \eta(\tilde{\pi}) η ( π ~ ) η ( π ) \eta(\pi) η ( π ) 累计优势 。只要每个状态 s 上的期望优势是非负的, η \eta η
状态权重近似
然而,由于估计误差和函数逼近误差的存在,几乎肯定存在某些状态 s s s ρ π ~ ( s ) \rho_{\tilde{\pi}}(s) ρ π ~ ( s ) π ~ \tilde{\pi} π ~
π → P ( s t ∣ π ) → ρ π ( s ) → η ( π ) (7) \pi \rightarrow P(s_t | \pi) \rightarrow \rho_\pi(s) \rightarrow \eta(\pi) \tag{7}
π → P ( s t ∣ π ) → ρ π ( s ) → η ( π ) ( 7 )
看式(7)的依赖关系,我们在优化 π \pi π ρ π ( s ) \rho_{{\pi}}(s) ρ π ( s )
L π ( π ~ ) = η ( π ) + ∑ s ρ π ( s ) ∑ a π ~ ( a ∣ s ) A π ( s , a ) (8) L_\pi(\tilde{\pi})=\eta(\pi)+\sum_s \rho_\pi(s) \sum_a \tilde{\pi}(a \mid s) A_\pi(s, a) \tag{8}
L π ( π ~ ) = η ( π ) + s ∑ ρ π ( s ) a ∑ π ~ ( a ∣ s ) A π ( s , a ) ( 8 )
注意,ρ π ~ ( s ) \rho_{\tilde{\pi}}(s) ρ π ~ ( s ) ρ π ( s ) \rho_{{\pi}}(s) ρ π ( s )
L π θ 0 ( π θ 0 ) = η ( π θ 0 ) , ∇ θ L π θ 0 ( π θ ) ∣ θ = θ 0 = ∇ θ η ( π θ ) ∣ θ = θ 0 (9) \begin{aligned}
L_{\pi_{\theta_0}}\left(\pi_{\theta_0}\right) & =\eta\left(\pi_{\theta_0}\right), \\
\left.\nabla_\theta L_{\pi_{\theta_0}}\left(\pi_\theta\right)\right|_{\theta=\theta_0} & =\left.\nabla_\theta \eta\left(\pi_\theta\right)\right|_{\theta=\theta_0}
\end{aligned} \tag{9}
L π θ 0 ( π θ 0 ) ∇ θ L π θ 0 ( π θ ) θ = θ 0 = η ( π θ 0 ) , = ∇ θ η ( π θ ) ∣ θ = θ 0 ( 9 )
如式(9)所示,在起始点,近似值和真实值是相等的,它们的梯度(变化方向)也是完全一致的。就是说,如果只走极小的一步,优化 L L L η \eta η
有同学可能会有一丝疑惑,π ~ ( a ∣ s ) \tilde{\pi}(a \mid s) π ~ ( a ∣ s ) π ~ \tilde{\pi} π ~ L L L ρ \rho ρ π \pi π ρ \rho ρ π ~ ( a ∣ s ) \tilde{\pi}(a \mid s) π ~ ( a ∣ s ) ρ π ~ ( s ) \rho_{\tilde{\pi}}(s) ρ π ~ ( s )
保守策略迭代
Sham Kakade 和 John Langford 在 2002 Approximately Optimal Approximate Reinforcement Learning [3] 中提出保守策略迭代的策略更新方法,并为策略性能提升 η \eta η
令 π old \pi_{\text{old}} π old
π ′ = arg max π ′ L π o l d ( π ′ ) (10) \pi^{\prime}=\arg \max _{\pi^{\prime}} L_{\pi_{\mathrm{old}}}\left(\pi^{\prime}\right) \tag{10}
π ′ = arg π ′ max L π old ( π ′ ) ( 10 )
新的策略 π new \pi_{\text{new}} π new
π n e w ( a ∣ s ) = ( 1 − α ) π o l d ( a ∣ s ) + α π ′ ( a ∣ s ) (11) \pi_{new}(a|s) = (1 - \alpha)\pi_{old}(a|s) + \alpha\pi'(a|s) \tag{11}
π n e w ( a ∣ s ) = ( 1 − α ) π o l d ( a ∣ s ) + α π ′ ( a ∣ s ) ( 11 )
新策略不是直接跳到最好的 π ′ \pi' π ′ ( 1 − α ) (1-\alpha) ( 1 − α ) α \alpha α
η ( π new ) ≥ L π old ( π new ) − 2 ϵ γ ( 1 − γ ) 2 α 2 where ϵ = max s ∣ E a ∼ π ′ ( a ∣ s ) [ A π ( s , a ) ] ∣ (12) \begin{aligned}
\eta\left(\pi_{\text {new }}\right) & \geq L_{\pi_{\text {old }}}\left(\pi_{\text {new }}\right)-\frac{2 \epsilon \gamma}{(1-\gamma)^2} \alpha^2 \\
& \text { where } \epsilon=\max _s\left|\mathbb{E}_{a \sim \pi^{\prime}(a \mid s)}\left[A_\pi(s, a)\right]\right|
\end{aligned} \tag{12}
η ( π new ) ≥ L π old ( π new ) − ( 1 − γ ) 2 2 ϵ γ α 2 where ϵ = s max E a ∼ π ′ ( a ∣ s ) [ A π ( s , a ) ] ( 12 )
L π o l d ( π n e w ) L_{\pi_{old}}(\pi_{new}) L π o l d ( π n e w ) α 2 \alpha^2 α 2 α \alpha α L L L η \eta η 绝对不会下降 。即,在 α \alpha α α \alpha α η \eta η
ϵ \epsilon ϵ π ′ \pi' π ′ π \pi π 最大潜在提升幅度 ,它是一个“上限值”。在证明下界时,我们通常假设最坏的情况。这个 ϵ \epsilon ϵ π ′ \pi' π ′ s s s ϵ \epsilon ϵ
这里找下界(最坏情况)和减 max 的逻辑是:由于新策略 π ′ \pi' π ′ ϵ \epsilon ϵ ϵ \epsilon ϵ ϵ \epsilon ϵ
惩罚项等同于风险,前面那项 L L L α \alpha α α \alpha α α \alpha α 最大提升幅度 ϵ \epsilon ϵ 算出来的损失项,只要我步子迈得足够小(α \alpha α 预期的收益一定能盖过最坏情况下的损失。
TRPO 论文说它 “unwieldy and restrictive in practice”,原因是:
要求新策略必须是两个策略的“线性混合”。但在深度学习中,我们通常是更新权重 θ \theta θ θ \theta θ π θ n e w \pi_{\theta_{new}} π θ n e w
α \alpha α
既然“线性混合”可以通过限制 α \alpha α 新旧策略的 KL 散度 足够小,是不是也能推导出一个类似的下界?TRPO 的 TR 来了。
TRPO算法
总变差散度
论文认为公式 (12) 中的策略改进下界可以推广到一般随机策略(而不仅仅是混合策略),具体做法是,用一个衡量 π \pi π π ~ \tilde{\pi} π ~ α \alpha α 总变差散度 (Total Variation Divergence),
D T V ( p ∥ q ) = 1 2 ∑ i ∣ p i − q i ∣ (13) D_{\mathrm{TV}}(p \| q)=\frac{1}{2} \sum_i\left|p_i-q_i\right| \tag{13}
D TV ( p ∥ q ) = 2 1 i ∑ ∣ p i − q i ∣ ( 13 )
其中 p , q p, q p , q
在强化学习的某个状态 s s s p p p π o l d ( a ∣ s ) \pi_{old}(a|s) π o l d ( a ∣ s ) q q q π n e w ( a ∣ s ) \pi_{new}(a|s) π n e w ( a ∣ s ) p − q p-q p − q 1 1 1
进一步定义:
D T V max ( π , π ~ ) = max s D T V ( π ( ⋅ ∣ s ) ∥ π ~ ( ⋅ ∣ s ) ) (14) D^{\max}_{\mathrm{TV}}(\pi, \tilde{\pi})
= \max_{s} D_{\mathrm{TV}}(\pi(\cdot|s)\,\|\,\tilde{\pi}(\cdot|s)) \tag{14}
D TV m a x ( π , π ~ ) = s max D TV ( π ( ⋅ ∣ s ) ∥ π ~ ( ⋅ ∣ s )) ( 14 )
即在所有状态 s s s
TRPO 的作者证明了一个极其重要的结论:前面那个混合比例 α \alpha α D T V m a x D_{TV}^{max} D T V ma x 。
定理一 :我们令 α = D T V m a x \alpha = D_{TV}^{max} α = D T V ma x
η ( π new ) ≥ L π old ( π new ) − 4 ϵ γ ( 1 − γ ) 2 α 2 where ϵ = max s , a ∣ A π ( s , a ) ∣ (15) \begin{aligned}
\eta\left(\pi_{\text {new }}\right) & \geq L_{\pi_{\text {old }}}\left(\pi_{\text {new }}\right)-\frac{4 \epsilon \gamma}{(1-\gamma)^2} \alpha^2 \\
& \text { where } \epsilon=\max _{s,a}\left|A_\pi(s, a)\right|
\end{aligned} \tag{15}
η ( π new ) ≥ L π old ( π new ) − ( 1 − γ ) 2 4 ϵ γ α 2 where ϵ = s , a max ∣ A π ( s , a ) ∣ ( 15 )
这就是论文的定理一,文中给了两种证明思路:
耦合。假设有两个分布 p p p q q q α \alpha α a o l d a_{old} a o l d a n e w a_{new} a n e w 1 − α 1-\alpha 1 − α α \alpha α 1 − α 1-\alpha 1 − α α \alpha α
扰动理论。我们可以把策略的变化看作是对环境动力学系统的一种「微小扰动」,原本的平衡状态是旧分布 ρ π \rho_{\pi} ρ π α \alpha α ρ π ~ \rho_{\tilde{\pi}} ρ π ~
定理一告诉我们,只要约束 D T V D_{TV} D T V L L L α \alpha α
从TV到KL散度
根据 “Asymptopia: an exposition of statistical asymptotic theory”,总变差散度与 KL 散度之间存在如下关系:
D T V ( p ∥ q ) 2 ≤ D K L ( p ∥ q ) (16) D_{TV}(p \parallel q)^2 \leq D_{KL}(p \parallel q) \tag{16}
D T V ( p ∥ q ) 2 ≤ D K L ( p ∥ q ) ( 16 )
显然,把定理一的 α \alpha α
η ( π ~ ) ≥ L π ( π ~ ) − C D K L max ( π , π ~ ) , where C = 4 ϵ γ ( 1 − γ ) 2 (17) \begin{aligned}
\eta(\tilde{\pi}) & \ge L_{\pi}(\tilde{\pi}) - C \, D_{\mathrm{KL}}^{\max}(\pi, \tilde{\pi}),
\\
& \text{where } C = \frac{4 \epsilon \gamma}{(1 - \gamma)^2}
\end{aligned} \tag{17}
η ( π ~ ) ≥ L π ( π ~ ) − C D KL m a x ( π , π ~ ) , where C = ( 1 − γ ) 2 4 ϵ γ ( 17 )
有同学肯定好奇,既然 TV 好好的,为啥要换成 KL 呢?主要有以下几个原因:
导数友好 :D T V D_{TV} D T V D K L D_{KL} D K L 信息论 :KL 散度衡量的是“信息的损失”,在概率模型优化中有着天然的统治地位。二阶优化的基石 :最重要的一点——KL 散度的二阶导数就是 Fisher 信息矩阵 (FIM) (可参考《Reward建模新范式:无验证RL——当模型只能相信自己,会发生什么? | 长琴 [4] 》)。这让 TRPO 能够利用曲率信息(自然梯度)来实现稳定的步长控制,而 TV 散度很难做到这一点。
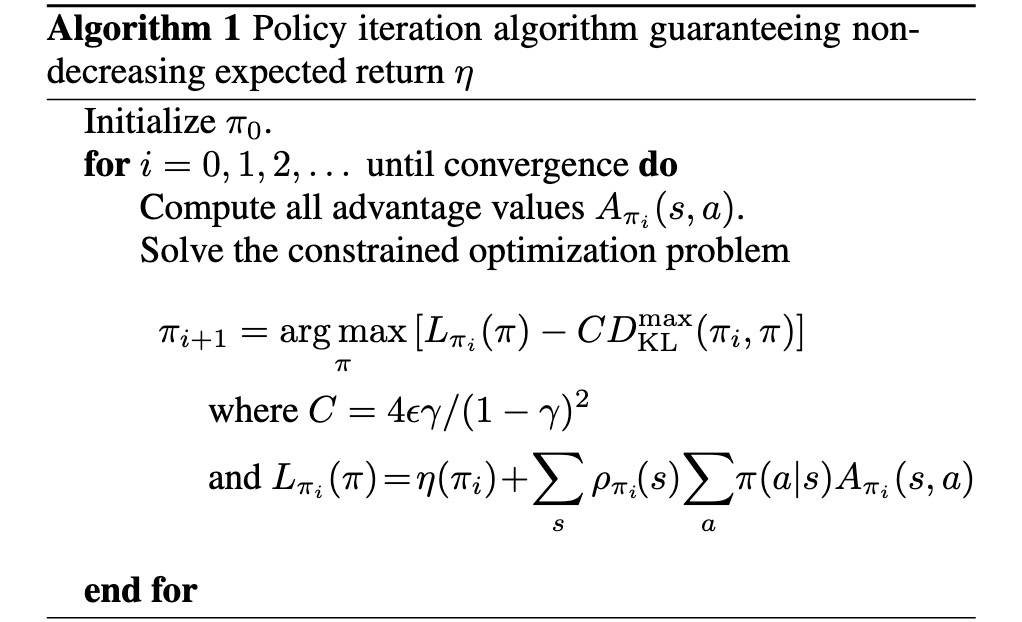
下面的算法描述了基于公式 (17) 中策略改进下界的近似策略迭代方法:
假设我们能够精确评估所有的优势值 A π ( s , a ) A_\pi(s, a) A π ( s , a )
定义 M i ( π ) = L π i ( π ) − C D K L max ( π i , π ) M_i(\pi) = L_{\pi_i}(\pi) - C D_{KL}^{\max}(\pi_i, \pi) M i ( π ) = L π i ( π ) − C D K L m a x ( π i , π )
η ( π i + 1 ) ≥ M i ( π i + 1 ) (18) \eta(\pi_{i+1}) \geq M_i(\pi_{i+1}) \tag{18}
η ( π i + 1 ) ≥ M i ( π i + 1 ) ( 18 )
又有:
M i ( π i ) = L π i ( π i ) − C D K L max ( π i , π i ) = L π i ( π i ) = η ( π i ) (19) M_i(\pi_i) = L_{\pi_i}(\pi_i) - C D_{KL}^{\max}(\pi_i, \pi_i) = L_{\pi_i}(\pi_i) = \eta(\pi_i) \tag{19}
M i ( π i ) = L π i ( π i ) − C D K L m a x ( π i , π i ) = L π i ( π i ) = η ( π i ) ( 19 )
于是有:
η ( π i + 1 ) − η ( π i ) ≥ M i ( π i + 1 ) − M i ( π i ) (20) \eta(\pi_{i+1})- \eta(\pi_i) \geq M_i(\pi_{i+1}) - M_i(\pi_i) \tag{20}
η ( π i + 1 ) − η ( π i ) ≥ M i ( π i + 1 ) − M i ( π i ) ( 20 )
因此,每一次迭代中最大化 M i M_i M i M i ( π i + 1 ) ≥ M i ( π i ) M_i(\pi_{i+1}) \geq M_i(\pi_i) M i ( π i + 1 ) ≥ M i ( π i ) η \eta η
Algorithm 1 被归类为 MM 算法 (Minorization-Maximization)的一种,这类算法还包括 EM。在 MM 算法语境中,M i M_i M i π i \pi_i π i η \eta η η \eta η
TRPO主角登场
前面我们是在不考虑策略参数化形式,并假设可以在所有状态上精确评估策略的前提下,讨论了策略优化问题。这小节我们将在有限样本和任意参数化形式的条件下,从理论基础出发,推导出一个可实践的算法。考虑带参数的策略 π θ ( a ∣ s ) \pi_\theta(a|s) π θ ( a ∣ s ) θ \theta θ θ \theta θ
式 (17) 可以写为:
η ( θ ) ≥ L θ old ( θ ) − C D K L max ( θ old , θ ) , where C = 4 ϵ γ ( 1 − γ ) 2 (21) \begin{aligned}
\eta(\theta) & \ge L_{\theta_{\text{old}}}(\theta) - C \, D_{\mathrm{KL}}^{\max}(\theta_\text{old}, \theta),
\\
& \text{where } C = \frac{4 \epsilon \gamma}{(1 - \gamma)^2}
\end{aligned} \tag{21}
η ( θ ) ≥ L θ old ( θ ) − C D KL m a x ( θ old , θ ) , where C = ( 1 − γ ) 2 4 ϵ γ ( 21 )
θ = θ old \theta = \theta_{\text{old}} θ = θ old
因此,通过求解如下优化问题,可以保证提升真实目标 η \eta η
max θ [ L θ old ( θ ) − C D K L max ( θ old , θ ) ] (22) \max_\theta \left[L_{\theta_{\text{old}}}(\theta) - C \, D_{\mathrm{KL}}^{\max}(\theta_\text{old}, \theta) \right] \tag{22}
θ max [ L θ old ( θ ) − C D KL m a x ( θ old , θ ) ] ( 22 )
然而实践中,如果直接使用理论中建议的惩罚系数 C C C C C C ( 1 − γ ) 2 (1-\gamma)^2 ( 1 − γ ) 2 γ = 0.99 \gamma = 0.99 γ = 0.99 0.0001 0.0001 0.0001 C C C L L L
为了在保持稳定性的同时实现更大的更新步长 ,作者提出将“惩罚项”改为“置信域约束(Trust Region Constraint) ”,对新旧策略之间的 KL 散度施加约束:
max θ L θ o l d ( θ ) subject to D K L max ( θ o l d , θ ) ≤ δ (23) \begin{aligned}
\max_{\theta} \quad & L_{\theta_{old}}(\theta) \\
\text{subject to} \quad & D_{KL}^{\max}(\theta_{old}, \theta) \leq \delta
\end{aligned} \tag{23}
θ max subject to L θ o l d ( θ ) D K L m a x ( θ o l d , θ ) ≤ δ ( 23 )
从原来的偏离惩罚,调整为在一个信任限制区域内找最大提升。这种处理方式被称为 TRPO (Trust Region Policy Optimization) :
摆脱超参敏感性 :理论上的 C C C δ \delta δ D K L ≤ 0.01 D_{KL} \leq 0.01 D K L ≤ 0.01 允许“激进”更新 :只要更新后的策略在“信任区域”内,即使它改动了参数的非线性组合,数学上依然能通过近似保证性能稳定性。
这个优化问题要求在状态空间的每一个点上 ,KL 散度都被限制在一个界内。这一约束来源于理论推导,但由于约束数量过多,在实际中很难直接求解。转而采用一种启发式近似方法,用平均 KL 散度 来替代逐状态约束,将“最大值”替换为“期望值”。
D ˉ K L ρ ( θ 1 , θ 2 ) : = E s ∼ ρ [ D K L ( π θ 1 ( ⋅ ∣ s ) ∥ π θ 2 ( ⋅ ∣ s ) ) ] (24) \bar{D}^{\rho}_{\mathrm{KL}}(\theta_1, \theta_2)
:= \mathbb{E}_{s \sim \rho}\Big[ D_{\mathrm{KL}}\big(\pi_{\theta_1}(\cdot \mid s)\ \|\ \pi_{\theta_2}(\cdot \mid s)\big) \Big] \tag{24}
D ˉ KL ρ ( θ 1 , θ 2 ) := E s ∼ ρ [ D KL ( π θ 1 ( ⋅ ∣ s ) ∥ π θ 2 ( ⋅ ∣ s ) ) ] ( 24 )
也就是说,我们不再保证“在所有状态下改动都不大”,而是保证“在平均意义上,或者说在经常遇到的状态下,改动是受限的 ”。
从 max \max max E \mathbb{E} E
采样计算 :因为是期望值,我们可以通过智能体在环境中收集到的样本轨迹来估算这个平均 KL 散度。简化优化 :把无数个约束合并成了一个单一的约束。在数学上允许我们使用共轭梯度法高效地求解约束优化问题。
这一步虽然在理论严谨性上退后了一小步(不再是 100% 保证单调提升),但在实用性上前进了一大步。它承认了在处理复杂 AI 模型时,我们必须用统计上的稳定性 来替代绝对的局部稳定性 。
最终的优化目标:
max θ L θ o l d ( θ ) subject to D ˉ K L ρ θ old ( θ o l d , θ ) ≤ δ (25) \begin{aligned}
\max_{\theta} \quad & L_{\theta_{old}}(\theta) \\
\text{subject to} \quad & \bar{D}_{KL}^{\rho_{\theta_\text{old}}}(\theta_{old}, \theta) \leq \delta
\end{aligned} \tag{25}
θ max subject to L θ o l d ( θ ) D ˉ K L ρ θ old ( θ o l d , θ ) ≤ δ ( 25 )
从理论到实践
三个变换
之前的理论推导中,无论是收益函数 L L L
首先把式 (25) 展开(结合式 (8)):
max θ ∑ s ρ θ old ( s ) ∑ a π θ ( a ∣ s ) A θ old ( s , a ) subject to D ˉ K L ρ θ old ( θ old , θ ) ≤ δ . (26) \begin{aligned}
\max_{\theta} \quad &
\sum_{s} \rho_{\theta_{\text{old}}}(s)
\sum_{a} \pi_{\theta}(a \mid s)\, A_{\theta_{\text{old}}}(s,a) \\
\text{subject to} \quad &
\bar{D}_{\mathrm{KL}}^{\rho_{\theta_{\text{old}}}}
(\theta_{\text{old}}, \theta) \le \delta .
\end{aligned} \tag{26}
θ max subject to s ∑ ρ θ old ( s ) a ∑ π θ ( a ∣ s ) A θ old ( s , a ) D ˉ KL ρ θ old ( θ old , θ ) ≤ δ . ( 26 )
我们可以把这个求和公式拆解成三个部分:
∑ s ρ θ o l d ( s ) \sum_s \rho_{\theta_{old}}(s) ∑ s ρ θ o l d ( s ) s s s s s s ∑ a π θ ( a ∣ s ) \sum_a \pi_\theta(a|s) ∑ a π θ ( a ∣ s ) s s s a a a A θ o l d ( s , a ) A_{\theta_{old}}(s, a) A θ o l d ( s , a ) a a a a a a
连起来看,它就是一个期望值,这个优化目标的本质是:“寻找一组新参数 θ \theta θ s s s A > 0 A > 0 A > 0 ”
为了便于计算,论文做了三个变换。
第一个变换,论文将第一项替换为期望值:1 ( 1 − γ ) E s ∼ ρ θ old [ ⋅ ] \frac{1}{(1 - \gamma)} \mathbb{E}_{s \sim \rho_{\theta_{\text{old}}}}[\cdot] ( 1 − γ ) 1 E s ∼ ρ θ old [ ⋅ ] ∑ s \sum_s ∑ s
第二个变换,论文将第三项替换为 Q,简化计算(计算 A 需要 V),且不影响梯度(和 A 最后算出来的更新方向是一样的)。因为 A ( s , a ) = Q ( s , a ) − V ( s ) A(s, a) = Q(s, a) - V(s) A ( s , a ) = Q ( s , a ) − V ( s ) V ( s ) V(s) V ( s ) a a a θ \theta θ V ( s ) V(s) V ( s ) θ \theta θ
第三个变换,将动作求和 ∑ a \sum_a ∑ a E a ∼ q \mathbb{E}_{a \sim q} E a ∼ q q q q q q q π θ \pi_\theta π θ π θ ( a ∣ s ) q ( a ∣ s ) \frac{\pi_\theta(a|s)}{q(a|s)} q ( a ∣ s ) π θ ( a ∣ s ) π θ \pi_\theta π θ
用 q q q s n s_n s n
∑ a π θ ( a ∣ s n ) A θ old ( s n , a ) = E a ∼ q [ π θ ( a ∣ s n ) q ( a ∣ s n ) A θ old ( s n , a ) ] (27) \sum_{a} \pi_{\theta}(a|s_n) A_{\theta_{\text{old}}}(s_n, a) = \mathbb{E}_{a \sim q} \left[ \frac{\pi_{\theta}(a|s_n)}{q(a|s_n)} A_{\theta_{\text{old}}}(s_n, a) \right] \tag{27}
a ∑ π θ ( a ∣ s n ) A θ old ( s n , a ) = E a ∼ q [ q ( a ∣ s n ) π θ ( a ∣ s n ) A θ old ( s n , a ) ] ( 27 )
最终,式 (26) 等价于如下期望形式:
max θ E s ∼ ρ θ old , a ∼ q [ π θ ( a ∣ s ) q ( a ∣ s ) Q θ old ( s , a ) ] subject to E s ∼ ρ θ old [ D KL ( π θ old ( ⋅ ∣ s ) ∥ π θ ( ⋅ ∣ s ) ) ] ≤ δ . (28) \begin{aligned}
& \underset{\theta}{\operatorname{max}} \quad \mathbb{E}_{s \sim \rho_{\theta_{\text{old}}}, a \sim q} \left[ \frac{\pi_{\theta}(a|s)}{q(a|s)} Q_{\theta_{\text{old}}}(s, a) \right] \\
& \text{subject to } \mathbb{E}_{s \sim \rho_{\theta_{\text{old}}}} \left[ D_{\text{KL}}(\pi_{\theta_{\text{old}}}(\cdot|s) \parallel \pi_{\theta}(\cdot|s)) \right] \le \delta.
\end{aligned} \tag{28}
θ max E s ∼ ρ θ old , a ∼ q [ q ( a ∣ s ) π θ ( a ∣ s ) Q θ old ( s , a ) ] subject to E s ∼ ρ θ old [ D KL ( π θ old ( ⋅ ∣ s ) ∥ π θ ( ⋅ ∣ s )) ] ≤ δ . ( 28 )
剩下的工作就是将期望替换为样本平均值,并将 Q 值替换为经验估计值。
两种工程方案
关于如何通过具体的采样策略来填补数学公式中“期望值”和“Q值”的空白。作者提出了两种截然不同的数据收集方案:Single Path 和 Vine。
单路径方法比较简单,主要通过采样初始状态 s 0 ∼ ρ 0 s_0 \sim \rho_0 s 0 ∼ ρ 0 π θ old \pi_{\theta_{\text{old}}} π θ old ( s , a ) (s,a) ( s , a ) q ( a ∣ s ) = π θ old ( a ∣ s ) q(a|s) = \pi_{\theta_{\text{old}}}(a|s) q ( a ∣ s ) = π θ old ( a ∣ s ) Q θ old ( s , a ) Q_{\theta_{\text{old}}}(s, a) Q θ old ( s , a ) ( s t , a t ) (s_t, a_t) ( s t , a t )
藤蔓方法像玩单机游戏时不停地“存读档”,主要用于策略迭代类的方法,做法是,按照某种方式确定一组状态(Rollout Set),从这组状态中的每一个状态出发,分别执行多个不同的动作进行尝试(Rollouts)。核心步骤简单概括为:
生成主干轨迹。从起始状态 s 0 s_0 s 0 π θ i \pi_{\theta_i} π θ i
确定“锚点”(Rollout Set)。从跑出来的轨迹中,选出 N N N
多重分支尝试。对这 N N N s n s_n s n K K K a n , k a_{n,k} a n , k q q q
作者特别提到了如何选择这个“尝试动作”的分布 q q q
只要 q q q π θ i \pi_{\theta_i} π θ i
实践发现:
连续任务(如机器人走路) :直接让 q = π θ i q = \pi_{\theta_i} q = π θ i 离散任务(如 Atari 游戏) :使用均匀分布。即不再偏向旧策略,而是把所有可能的动作都平等地试一遍。探索性更强。
藤蔓方法的目的是降低 Q Q Q s n s_n s n
藤蔓方法的缺点在于,对模拟器的调用次数更多。而且,“从分叉点集合中的每个状态出发生成多条轨迹” 限制了该算法只能应用于可以将系统重置到任意状态的场景。相比之下,单路径方法不需要状态重置,可以直接在物理系统上实现。
表格对比如下:
单路径
藤蔓
性能
方差高,A 估算精度低
方差低,A 估算精度高
成本
低
高,计算量大
复杂度
低,无要求
高,系统必须能重置到任意状态
场景
物理世界
实验室
其实,藤蔓方法看起来有点像 BoN(Best-of-N),它本质上就是为了更准地估算那组 Prompt 的优势值,和现在的思维链采样的逻辑异曲同工。
Vine模式技巧
重点在于如何降低方差以及在不同动作空间下如何构建目标函数的估算器。
使用公共随机数 (Common Random Numbers) 降低方差
在同一状态 s n s_n s n K K K 完全相同的随机数序列 来生成环境噪声。确保不同动作之间 Q Q Q 动作本身 引起的,而不是因为某次运气好遇到了较小的噪声。
有限离散动作空间精确求和
如果动作空间很小且是有限的,不需要采样,可以直接“暴力”遍历所有可能的动作。
L n ( θ ) = ∑ k = 1 K π θ ( a k ∣ s n ) Q ^ ( s n , a k ) (29) L_n(\theta) = \sum_{k=1}^{K} \pi_{\theta}(a_k|s_n) \hat{Q}(s_n, a_k) \tag{29}
L n ( θ ) = k = 1 ∑ K π θ ( a k ∣ s n ) Q ^ ( s n , a k ) ( 29 )
其中,动作空间 A = a 1 , a 2 , . . . , a K A = {a_1, a_2, . . . , a_K } A = a 1 , a 2 , ... , a K
连续/大动作空间用自归一化估算器
无法遍历,只能靠采样,文章引入自归一化重要性采样 (Self-Normalized Importance Sampling, SNIS),更多关于自归一化可参考附录2。
L n ( θ ) = ∑ k = 1 K π θ ( a n , k ∣ s n ) π θ old ( a n , k ∣ s n ) Q ^ ( s n , a n , k ) ∑ k = 1 K π θ ( a n , k ∣ s n ) π θ old ( a n , k ∣ s n ) (30) L_n(\theta) = \frac{\sum_{k=1}^{K} \frac{\pi_\theta(a_{n,k}|s_n)}{\pi_{\theta_{\text{old}}}(a_{n,k}|s_n)} \hat{Q}(s_n, a_{n,k})}{\sum_{k=1}^{K} \frac{\pi_\theta(a_{n,k}|s_n)}{\pi_{\theta_{\text{old}}}(a_{n,k}|s_n)}} \tag{30}
L n ( θ ) = ∑ k = 1 K π θ old ( a n , k ∣ s n ) π θ ( a n , k ∣ s n ) ∑ k = 1 K π θ old ( a n , k ∣ s n ) π θ ( a n , k ∣ s n ) Q ^ ( s n , a n , k ) ( 30 )
分子是标准的带权重 Q Q Q × Q \times Q × Q
无需 Baseline :普通策略梯度通常需要减去一个 V ( s ) V(s) V ( s ) 数值稳定性 :即使 Q Q Q 平移不变性 [5] ,都是利用“归一化结构消掉公共项”。不过 softmax 是概率分布本身不变,SNIS 是值会变(+常数c),但梯度不变 。
总的来说,动作少用 Equation (29) 直接算,动作多/连续用 Equation (30) 采样算,并用“公共随机数”来降低方差。最后,对所有选中的状态 s n s_n s n L L L θ \theta θ
实施流程
三个步骤
具体实施有三个核心步骤:
数据采集:根据环境条件(是否有模拟器重置功能),选择 Single Path 或 Vine 方案。收集一系列状态-动作对 ( s , a ) (s, a) ( s , a ) Q Q Q
构造目标函数与约束:利用数据构造出公式 (28) 中定义的估算目标函数(预期收益提升)和平均 KL 散度约束。
利用共轭梯度 (CG) 与线搜索求解:前者用来近似求解带约束的优化问题,后者在前者确定的方向上寻找最佳步长。
用Hessian构建FIM
重点看第三步,在求解约束优化问题时,我们需要知道 KL 散度随参数 θ \theta θ
论文通过解析计算 KL 散度的 Hessian 矩阵而非使用梯度的协方差矩阵来构建 Fisher 信息矩阵(FIM),具体来说,是:
1 N ∑ n = 1 N ∂ 2 ∂ θ i ∂ θ j D KL ( π θ old ( ⋅ ∣ s n ) ∥ π θ ( ⋅ ∣ s n ) ) (31) \frac{1}{N} \sum_{n=1}^N \frac{\partial^2}{\partial \theta_i \partial \theta_j} D_{\text{KL}}(\pi_{\theta_{\text{old}}}(\cdot|s_n) \parallel \pi_{\theta}(\cdot|s_n)) \tag{31}
N 1 n = 1 ∑ N ∂ θ i ∂ θ j ∂ 2 D KL ( π θ old ( ⋅ ∣ s n ) ∥ π θ ( ⋅ ∣ s n )) ( 31 )
而不是:
1 N ∑ n = 1 N ∂ ∂ θ i log π θ ( a n ∣ s n ) ∂ ∂ θ j log π θ ( a n ∣ s n ) (32) \frac{1}{N} \sum_{n=1}^N \frac{\partial}{\partial \theta_i} \log \pi_{\theta}(a_n|s_n) \frac{\partial}{\partial \theta_j} \log \pi_{\theta}(a_n|s_n) \tag{32}
N 1 n = 1 ∑ N ∂ θ i ∂ log π θ ( a n ∣ s n ) ∂ θ j ∂ log π θ ( a n ∣ s n ) ( 32 )
也就是直接对 KL 散度的公式求关于参数 θ \theta θ s n s_n s n a n a_n a n
论文指出,在大规模训练场景下,选择解析 Hessian 具有显著的计算优势,它免去了存储稠密海森矩阵或整批轨迹所有策略梯度的需求。结合共轭梯度法,可以只计算“Hessian 与向量的乘积”,而不需要显式地算出整个 Hessian 矩阵,这极大地降低了显存占用。实验结果表明,策略的改进速率与使用经验型 FIM 时相当。
为什么要算FIM
有同学可能有疑惑:为什么要算 Fisher 矩阵?原因很简单:如果不使用 Fisher 矩阵,算法可能会在某些敏感的方向上迈步过大,导致策略突然“崩溃”(改动过大导致性能骤降)。 通过引入 Fisher 矩阵,TRPO 实际上是在执行自然梯度下降(Natural Policy Gradient)的一种变体:
确保了参数更新的步长是在“概率分布空间”中衡量的,而不是在“参数数值空间”中衡量的。
保证了训练的稳定性和单调提升的特性。
关于 Fisher 矩阵的更多介绍,可以参考附录3。
相关工作
自然梯度
论文认为,**自然梯度 (Natural Policy Gradient, NPG)**是 TRPO 的一个特例。具体来说,如果对公式 (25) 进行简化:
目标函数线性化 :对代理目标函数 L L L 约束条件二次化 :对 KL 散度约束使用二次近似(即二阶泰勒展开,引入 Fisher 信息矩阵 A A A
就可以得到自然策略梯度:
maximize θ [ ∇ θ L θ old ( θ ) ∣ θ = θ old ⋅ ( θ − θ old ) ] subject to 1 2 ( θ old − θ ) T A ( θ old ) ( θ old − θ ) ≤ δ , where A ( θ old ) i j = ∂ ∂ θ i ∂ ∂ θ j E s ∼ ρ π [ D KL ( π ( ⋅ ∣ s , θ old ) ∥ π ( ⋅ ∣ s , θ ) ) ] ∣ θ = θ old (33) \begin{aligned}
& \operatorname*{maximize}_{\theta} \left[ \nabla_{\theta} L_{\theta_{\text{old}}}(\theta)|_{\theta=\theta_{\text{old}}} \cdot (\theta - \theta_{\text{old}}) \right] \\
& \text{subject to } \frac{1}{2} (\theta_{\text{old}} - \theta)^T A(\theta_{\text{old}}) (\theta_{\text{old}} - \theta) \le \delta, \\
& \text{where } A(\theta_{\text{old}})_{ij} = \\
& \qquad \frac{\partial}{\partial \theta_i} \frac{\partial}{\partial \theta_j} \mathbb{E}_{s \sim \rho_{\pi}} \left[ D_{\text{KL}}(\pi(\cdot|s, \theta_{\text{old}}) \parallel \pi(\cdot|s, \theta)) \right] |_{\theta=\theta_{\text{old}}}
\end{aligned} \tag{33}
θ maximize [ ∇ θ L θ old ( θ ) ∣ θ = θ old ⋅ ( θ − θ old ) ] subject to 2 1 ( θ old − θ ) T A ( θ old ) ( θ old − θ ) ≤ δ , where A ( θ old ) ij = ∂ θ i ∂ ∂ θ j ∂ E s ∼ ρ π [ D KL ( π ( ⋅ ∣ s , θ old ) ∥ π ( ⋅ ∣ s , θ )) ] ∣ θ = θ old ( 33 )
虽然 TRPO 与 NPG 在数学形式上很接近,但在更新方式上有一个细微但至关重要的区别:
NPG 的做法 :更新公式为 θ n e w = θ o l d + 1 λ A − 1 ∇ L \theta_{new} = \theta_{old} + \frac{1}{\lambda} A^{-1} \nabla L θ n e w = θ o l d + λ 1 A − 1 ∇ L 1 λ \frac{1}{\lambda} λ 1 TRPO 的做法 :每一次更新时强制执行 KL 散度约束 δ \delta δ
尽管这种区别看起来很微妙(都是超参,一个是调 λ \lambda λ δ \delta δ
特性 NPG 的 λ (Penalty) TRPO 的 δ (Constraint)
控制对象 参数更新的“强度”
概率分布变化的“幅度”
物理含义 抽象的权重系数
具体的距离(KL 散度值)
直观程度 很难解释 λ = 0.1 \lambda=0.1 λ = 0.1
δ = 0.01 \delta=0.01 δ = 0.01
鲁棒性 差。换个环境可能就要重新调 λ \lambda λ
强。一个 δ \delta δ
从更新的角度看,对 NPG,即使 λ \lambda λ A A A λ \lambda λ 发生巨变 。对 TRPO,无论当前的 Fisher 矩阵 A A A 永远不会超过 δ \delta δ 。
标准策略梯度
如果把 KL 散度约束换成最简单的 L 2 L_2 L 2 标准的策略梯度(Standard Policy Gradient) 。
maximize θ [ ∇ θ L θ old ( θ ) ∣ θ = θ old ⋅ ( θ − θ old ) ] subject to 1 2 ∥ θ − θ old ∥ 2 ≤ δ . (34) \begin{align}
& \underset{\theta}{\text{maximize}} \left[ \nabla_\theta L_{\theta_{\text{old}}}(\theta) \big|_{\theta=\theta_{\text{old}}} \cdot (\theta - \theta_{\text{old}}) \right] \\
& \text{subject to } \frac{1}{2} \|\theta - \theta_{\text{old}}\|^2 \le \delta.
\end{align} \tag{34}
θ maximize [ ∇ θ L θ old ( θ ) θ = θ old ⋅ ( θ − θ old ) ] subject to 2 1 ∥ θ − θ old ∥ 2 ≤ δ . ( 34 )
这说明标准策略梯度其实是假设参数空间的结构是平坦的(欧几里得空间),而 TRPO 认为参数空间是有曲率的(概率分布空间)。
如果完全去掉约束,直接去最大化未受限的代理目标函数 L L L 策略迭代(Policy Iteration) 。
其他方法对比
列举了其他几种方法也采用与公式 (25) 类似更新方式的方法。如下表所示:
对比方法 核心约束对象 与 TRPO 的区别
REPS 约束状态-动作的边缘分布 p ( s , a ) p(s, a) p ( s , a )
TRPO 约束的是条件分布 p ( a ∣ s ) p(a \mid s) p ( a ∣ s )
Levine & Abbeel 使用 KL 散度约束
他们的目的是为了让策略不要超出动力学模型有效的区域;而 TRPO 根本不尝试显式估算系统动力学。
Pirotta et al. 基于 Kakade 和 Langford 的成果进行泛化
虽然理论基础相似,但他们推导出的具体算法路径与 TRPO 不同。
其中:
小结
读完 TRPO,我们发现它不仅是一篇算法论文,更像是一篇“工程妥协手册”。它告诉我们,在面对复杂的神经网络和无限的状态空间时,如何通过一系列巧妙的近似(从 TV 到 KL,从 Max 到 Expectation,从 Hessian 求逆到 CG 迭代),将完美的数学定理转化为能跑在 GPU 上的代码。
虽然在今天的工业实践中,计算更简单的 PPO 抢占了一部分生态,而追求极致效率的 GRPO 正在大模型后训练方向大放异彩,但它们依然没逃出 TRPO 的三大铁律:重要性采样、信任区域和相对优势,后面出现的各种 GRPO 变体就更不用说了。
也许 TRPO 不是我们后训练的首选,但它的理论至今依然影响着每一次的大模型对齐训练。
附录
ρ的期望:到底是概率还是频率?
根据定义(式 (5)),ρ π ( s ) \rho_{\pi}(s) ρ π ( s ) s s s
ρ π ( s ) = ∑ t = 0 ∞ γ t P ( s t = s ∣ π ) (27) \rho_{\pi}(s) = \sum_{t=0}^{\infty} \gamma^t P(s_t = s | \pi) \tag{27}
ρ π ( s ) = t = 0 ∑ ∞ γ t P ( s t = s ∣ π ) ( 27 )
注意,ρ π ( s ) \rho_{\pi}(s) ρ π ( s )
如果我们想知道所有状态访问频率的总和,就把上面的式子对所有 s s s
∑ s ρ π ( s ) = ∑ s ( ∑ t = 0 ∞ γ t P ( s t = s ∣ π ) ) = ∑ t = 0 ∞ γ t ( ∑ s P ( s t = s ∣ π ) ) (28) \sum_{s} \rho_{\pi}(s) = \sum_{s} \left( \sum_{t=0}^{\infty} \gamma^t P(s_t = s | \pi) \right) = \sum_{t=0}^{\infty} \gamma^t \left( \sum_{s} P(s_t = s | \pi) \right) \tag{28}
s ∑ ρ π ( s ) = s ∑ ( t = 0 ∑ ∞ γ t P ( s t = s ∣ π ) ) = t = 0 ∑ ∞ γ t ( s ∑ P ( s t = s ∣ π ) ) ( 28 )
对于任何一个固定的时间步 t t t s s s t t t ∑ s P ( s t = s ∣ π ) = 1 \sum_{s} P(s_t = s | \pi) = 1 ∑ s P ( s t = s ∣ π ) = 1
∑ s ρ π ( s ) = ∑ t = 0 ∞ γ t ⋅ ( 1 ) = 1 + γ + γ 2 + γ 3 + … (29) \sum_{s} \rho_{\pi}(s) = \sum_{t=0}^{\infty} \gamma^t \cdot (1) = 1 + \gamma + \gamma^2 + \gamma^3 + \dots \tag{29}
s ∑ ρ π ( s ) = t = 0 ∑ ∞ γ t ⋅ ( 1 ) = 1 + γ + γ 2 + γ 3 + … ( 29 )
当 0 ≤ γ < 1 0 \le \gamma < 1 0 ≤ γ < 1
∑ s ρ π ( s ) = ∑ t = 0 ∞ γ t = 1 1 − γ (30) \sum_{s} \rho_{\pi}(s) =\sum_{t=0}^{\infin} \gamma^t = \frac{1}{1-\gamma} \tag{30}
s ∑ ρ π ( s ) = t = 0 ∑ ∞ γ t = 1 − γ 1 ( 30 )
当我们把 ∑ s ρ θ o l d ( s ) [ … ] \sum_{s} \rho_{\theta_{old}}(s) [\dots] ∑ s ρ θ o l d ( s ) [ … ] E s ∼ ρ θ o l d [ … ] \mathbb{E}_{s \sim \rho_{\theta_{old}}} [\dots] E s ∼ ρ θ o l d [ … ] d π ( s ) = ( 1 − γ ) ρ π ( s ) d_{\pi}(s) = (1-\gamma)\rho_{\pi}(s) d π ( s ) = ( 1 − γ ) ρ π ( s ) ρ \rho ρ d d d ( 1 − γ ) (1-\gamma) ( 1 − γ ) 1 1 − γ \frac{1}{1-\gamma} 1 − γ 1
原始式子 :∑ s ρ θ o l d ( s ) [ … ] \sum_s \rho_{\theta_{old}}(s) [ \dots ] ∑ s ρ θ o l d ( s ) [ … ] 构造 d d d :∑ s 1 1 − γ ⋅ ( 1 − γ ) ρ θ o l d ( s ) ⏟ d θ o l d ( s ) [ … ] \sum_s \frac{1}{1-\gamma} \cdot \underbrace{(1-\gamma)\rho_{\theta_{old}}(s)}_{d_{\theta_{old}}(s)} [ \dots ] ∑ s 1 − γ 1 ⋅ d θ o l d ( s ) ( 1 − γ ) ρ θ o l d ( s ) [ … ] 转为期望 :1 1 − γ ∑ s d θ o l d ( s ) [ … ] = 1 1 − γ E s ∼ d θ o l d [ … ] \frac{1}{1-\gamma} \sum_s d_{\theta_{old}}(s) [ \dots ] = \frac{1}{1-\gamma} \mathbb{E}_{s \sim d_{\theta_{old}}} [ \dots ] 1 − γ 1 ∑ s d θ o l d ( s ) [ … ] = 1 − γ 1 E s ∼ d θ o l d [ … ]
最后,再回答那个关键问题:ρ \rho ρ
首先,P ( s t = s ) P(s_t = s) P ( s t = s ) t t t s s s t t t 1 1 1
ρ π ( s ) \rho_{\pi}(s) ρ π ( s ) 期望访问次数 ,它的意思是:“如果在某个状态 s s s ρ \rho ρ γ \gamma γ ∑ γ t = 1 1 − γ \sum \gamma^t = \frac{1}{1-\gamma} ∑ γ t = 1 − γ 1
自归一化
我们可以把它看作一种“加权平均数”的变体。理论上,我们的目标 L n ( θ ) L_n(\theta) L n ( θ )
L n ( θ ) = E a ∼ π θ [ Q ( s , a ) ] L_n(\theta) = \mathbb{E}_{a \sim \pi_{\theta}} [Q(s, a)]
L n ( θ ) = E a ∼ π θ [ Q ( s , a )]
但我们只有从 π o l d \pi_{old} π o l d K K K
L n ( θ ) = E a ∼ π o l d [ π θ ( a ∣ s ) π o l d ( a ∣ s ) Q ( s , a ) ] ≈ 1 K ∑ k = 1 K w k Q ( s , a k ) L_n(\theta) = \mathbb{E}_{a \sim \pi_{old}} \left[ \frac{\pi_\theta(a|s)}{\pi_{old}(a|s)} Q(s, a) \right] \approx \frac{1}{K} \sum_{k=1}^K w_k Q(s, a_k)
L n ( θ ) = E a ∼ π o l d [ π o l d ( a ∣ s ) π θ ( a ∣ s ) Q ( s , a ) ] ≈ K 1 k = 1 ∑ K w k Q ( s , a k )
实际采样中,简单的平均(除以 K)可能有很大问题:如果 K K K K K K w k w_k w k L n ( θ ) L_n(\theta) L n ( θ )
为了消除这种采样不均衡,把 K 换成权重总和:
L n ( θ ) ≈ ∑ w k Q k ∑ w k L_n(\theta) \approx \frac{\sum w_k Q_k}{\sum w_k}
L n ( θ ) ≈ ∑ w k ∑ w k Q k
公式背后有两个数学直觉:
确保比例正确 :强制权重分配比例为 1。这样即便采样不均匀,它关注的也是“在这几个样本中,谁的相对权重更大”。消除平移量(Baseline) :如果给所有的 Q Q Q C C C Q ′ = Q + C Q' = Q + C Q ′ = Q + C
Fisher矩阵
在 TRPO 中,Fisher 信息矩阵 (Fisher Information Matrix, 简称 FIM) 是用来衡量参数变化对策略分布影响程度 的核心工具。
普通的梯度下降是在参数欧几里得空间里走的,但神经网络参数的改变并不等同于策略(概率分布)的改变 。Fisher 矩阵描述了参数空间的“曲率”,告诉我们:在当前的参数 θ \theta θ
在 TRPO 中,我们有一个核心约束:新旧策略之间的 KL 散度不能超过 δ \delta δ θ o l d \theta_{old} θ o l d A A A D K L ≤ δ D_{KL} \leq \delta D K L ≤ δ 1 2 Δ θ T A Δ θ ≤ δ \frac{1}{2} \Delta \theta^T A \Delta \theta \leq \delta 2 1 Δ θ T A Δ θ ≤ δ
部分信息参阅:Reward建模新范式:无验证RL——当模型只能相信自己,会发生什么? | 长琴 [4]
论文通过直接对 KL 散度求二阶导数来估算 A i j A_{ij} A ij
Reference
[1] paper: https://arxiv.org/abs/1502.05477 [2] VAPO:基于价值方法的新突破 | 长琴: https://yam.gift/2025/04/19/NLP/LLM-Training/2025-04-19-VAPO/ [3] 2002 Approximately Optimal Approximate Reinforcement Learning: https://people.eecs.berkeley.edu/~pabbeel/cs287-fa09/readings/KakadeLangford-icml2002.pdf [4] Reward建模新范式:无验证RL——当模型只能相信自己,会发生什么? | 长琴: https://yam.gift/2025/12/21/NLP/LLM-Training/2025-12-21-RM-New-Paradigm-Verify-Free-RL/ [5] 平移不变性: https://yam.gift/2026/02/01/NLP/LLM/2026-02-01-Flash-Attention-to-Streaming-Reduction/ [6] 2010 Relative Entropy Policy Search: https://www.ias.informatik.tu-darmstadt.de/uploads/Team/JanPeters/Peters2010_REPS.pdf [7] 2014 Learning neural network policies with guided policy search under unknown dynamics: https://people.eecs.berkeley.edu/~svlevine/papers/mfcgps.pdf [8] 2013 Safe policy iteration: https://proceedings.mlr.press/v28/pirotta13.html
本文已收录至 post-training-atlas —— 一份带观点、跨模态的后训练图谱与论文索引。如果你对相关话题有想法,欢迎来 Issues 拍砖。