大模型出来后一直在做这方面的后训练,从业务魔改到训练框架都做过,今年开始尝试设计新的算法,冲一冲 sota。大型的已经三次了,每次野心都很大,不过都没有特别成功。第一次是统一可验证/不可验证方向 GRPO,结果 sota 没有扩到更大 Size 模型;第二次是想一次解决 dense reward 的问题,还是差点意思;第三次是统一整个后训练(SFT、DPO、GRPO、OPD 等等)框架,目前看效果还没有特别明显。
后训练的论文看的有点多(感兴趣的朋友可以通过这个项目了解),有时候忽然有种不想看的感觉,来来回回就是那些做法,GRPO 火了,就猛改,整个链路每个点都被薅干;OPD 火了,GRPO 的方法拿过来再撸一遍。看多了,真有种看山还是山的感觉,有时候觉得索然无味。但是自己偏偏又没法稳定 sota,而且在这种红海里,其实能研究的点本身就很挤(换个方向就好很多)。
于是就想换换脑子,恰好一直对 Embodied 感兴趣,之前其实已经写过一篇《VLA Sim-Real 协同训练 | 长琴》了,那就继续这个方向吧,正好世界模型现在如火如荼,就读点这方面的工作看看。再者说,后训练为啥要区分模态呢?模态之间说不定还能彼此借鉴呢。
再说点题外话,很多人可能在想,现在 AI 都这么强了,还有必要看 paper 吗,AI 直接整理出来不香吗?的确如此,绝大多数论文(保守估计 95%)不需要认真读,现在水文在 AI 的助长下更多了,每篇都看就是浪费生命。但是一些好论文还是值得仔细研读的,这里的读其实是让脉络在我们自己脑海里展开、联结,形成新的认知。
我一直觉得认知改变最重要,远比学会某个算法或技巧更重要,咱们《技术与人》公众号的简介里就写着“技术改善世界,认知重塑思维”。在现在这个时代,更是如此,代码、复现、笔记,甚至解读其实都非常廉价,AI 能做的更好,真正有价值的是认知有没有被影响,知识点有没有 connect 起来,涌现出新的认知。你的输出要么是单点极限突破,要么是多点联合抽象(本站这个方向较多),这两个角度都是带有自身大量的 context,AI 几乎没法替代。尤其是多点联合,AI 即便知道你的 topic,也不可能写出和你一模一样的内容,甚至你们选的 paper 列表都大不相同。
好了,言归正传,今天看的论文是《2606 NVIDIA OmniDreams: Real-Time Generative World Model for Closed-Loop Autonomous Vehicle Simulation》,这是一篇解决仿真器/真实场景受限的工作,以 Cosmos 扩散模型为基础,通过真实场景数据 mid/post-training 实现以历史视频帧、当前仿真器状态和即时 action 作为条件,实时、自回归地生成逼真的传感器观测。
这里有个背景:生成观测数据往往可能难以和真实情况一致,尤其一些长尾、未知情况,那我们要如何在安全关键的长尾场景中测试 policy ,然后再部署呢?本文的做法是——借助生成式模型。论文不复杂,但非常完整,值得学习。虽然是自动驾驶场景,但其实其他场景也是类似的。
本文偏笔记记录,但对算法细节进行了详细地分析和扩展,算是从算法视角整理的一份学习记录吧,其实也算是“廉价”输出了,不过没办法,这个方向我自己也是新手,还处在加点状态,没法 connect,这些认知的积累是必要的。
数据
原始数据
真实场景视频切片(七个视角:前向广角、前向长焦、后向长焦、左前、右前、左后、右后)。
signal 数据
后训练的三个输入条件:
- 一个抽象的世界场景地图状态。
- 静态的高精地图(标签来自城市级地图)
- 动态交通参与者 3D 标注,3D 检测与跟踪以 10 FPS 帧率运行,再通过插值提升至 30 FPS
- policy/人的动作
- 一段描述环境条件的文本 prompt,可以在不修改底层场景几何结构的情况下,控制环境的外观,例如天气、光照和一天中的时间。使用 VLM 对视频片段进行描述,需要描述整体场景、天气、驾驶行为以及交通状况。10 秒为一个时间窗口进行描述生成,对于每个时间窗口生成短、中、长三种不同长度的描述。短中长分别对应 40、80、200 单词,训练时以 0.1 / 0.2 / 0.7 的概率被采样使用。
- 近期视觉历史。
数据整理与质量筛选
多阶段过滤管道过掉有问题数据:
- 删除传感器数据不可靠(如行驶轨迹出现跳变)、标注不可靠(如自动标注的物体存在较高不确定性)、预测结果存在分歧的序列。
- VLM 检测摄像头数据中不理想的视觉伪影,如色差,并移除受影响的视频片段。
- 基于行驶轨迹和视觉特征进行数据去重,对数据集中重复性较高的视频片段(如高速公路直线行驶)进行降采样。
数据构成
- RDS mid-training 数据:16,600 小时、300 万个视频片段。
- RDS-HQ-1M post-training 数据:4,944 小时、1,142,285 个视频片段,10s 占比 44%,20s 占比 56%。
- 测试数据:训练数据留出 5,000 个片段(其中 300 个额外有长的 60s 版本),针对不同场景类别进行均衡采样,覆盖:
- 道路使用者:骑行者、行人、摩托车、婴儿推车。
- 大型车辆:卡车、拖车。
- 天气与光照条件:雨天、雪天、雾天、夜间。
- 罕见的道路基础设施与场景:隧道、铁路道口、施工区域、事故现场。
模型
这部分差不多也是纯笔记记录。
这种实时交互类型最适合自回归,架构上是 causal diffusion,分单视角(正面,每步 8 帧)和多视角(前置、左交叉、右交叉、前置长焦,每步 16 帧)模型。
输入编码方式如下:
- 首帧:真实图像编码得到的干净 latent token,携带真实场景视觉特征,初始化生成,提供视觉条件。
- 文本 prompt:环境描述经文本编码器处理后的表示,cross attention 层注入,携带天气、光照、时间等语义。
- 抽象世界场景:结构化仿真器状态经小型 MLP 编码为 latent token,进入 transformer 前和 visual token 拼接在一起,携带车道线、交通设施、动态交通参与者等。
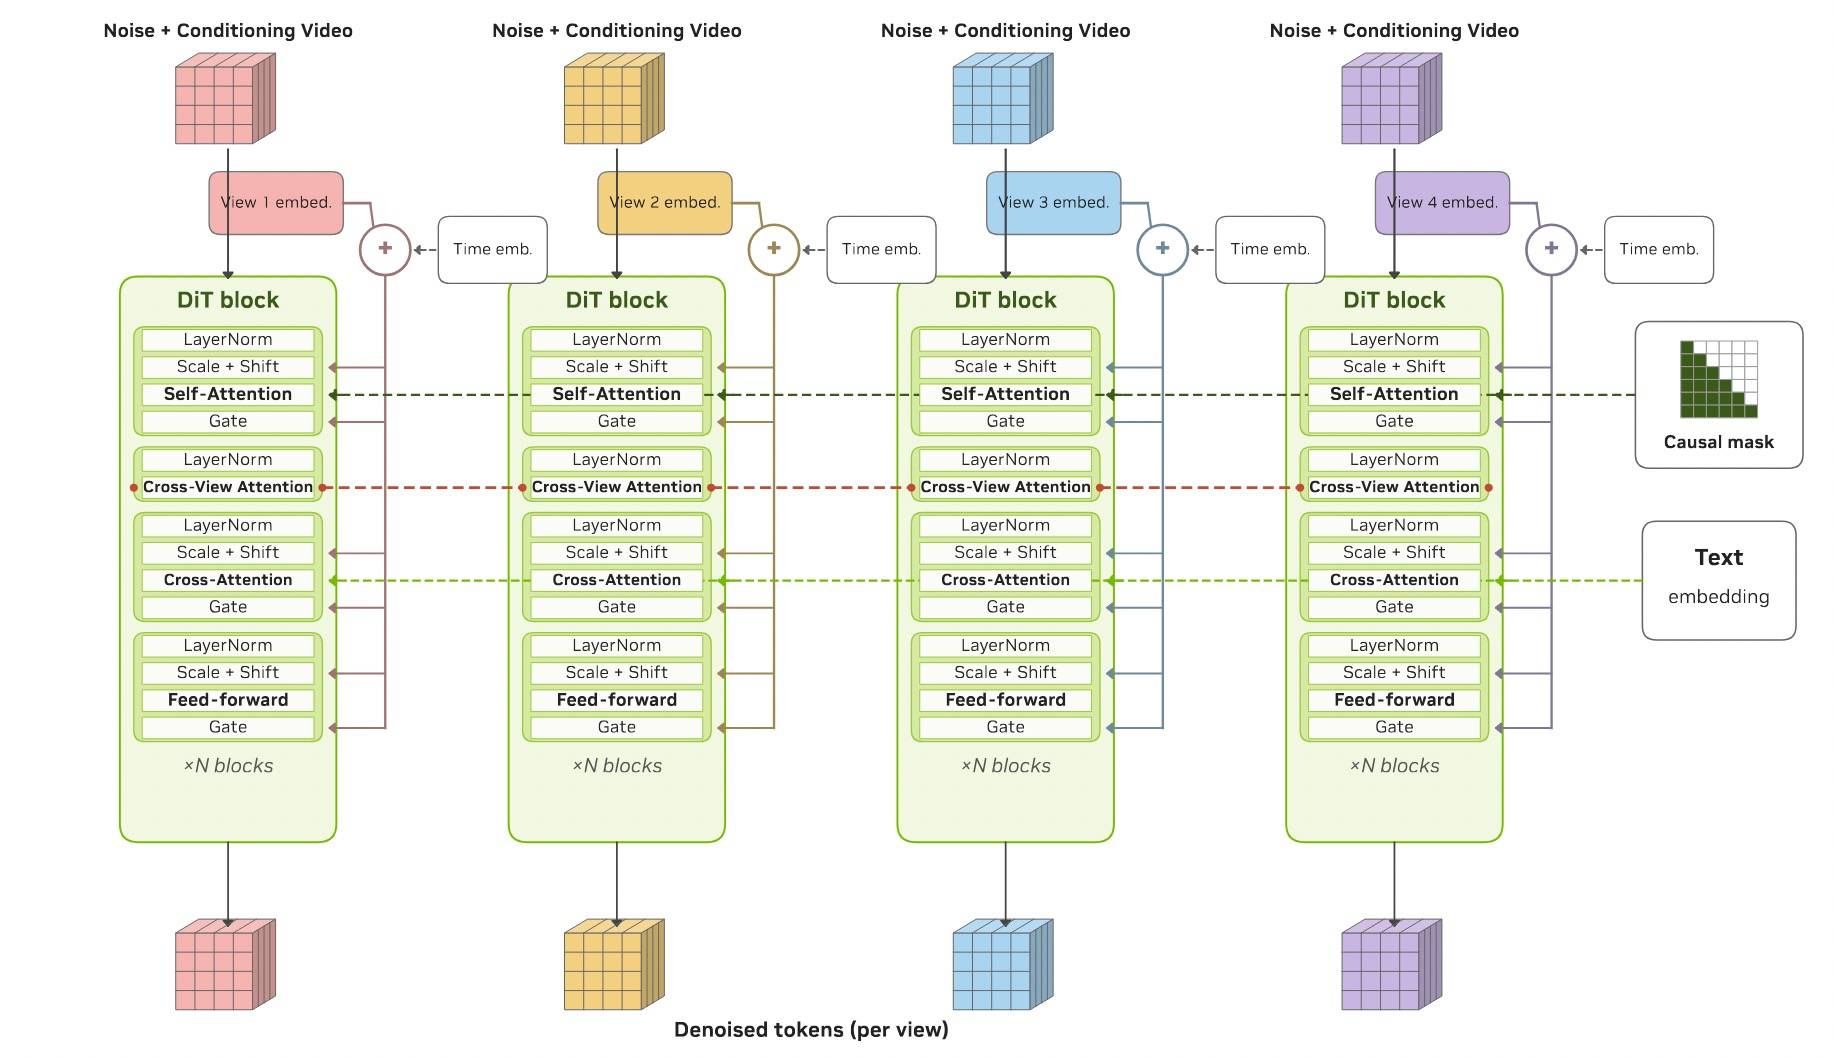
额外提一下多视角,这里每个摄像头视角都关联一个可学习的 embedding,并将其添加到 token 表示中,以标识对应的视角。而且每个视角都有各自的条件输入,包括文本 prompt、首帧 RGB 图像,以及与该摄像头相对应的结构化世界状态。所以,模型能够同时表示场景的共享结构和各个视角特有的视觉外观。
Naive 的建模方法是在所有时间步、所有视角的 token 之间执行完整的 self-attention,但这个复杂度相对于视角数量 N 和时间长度 T 是呈二次增长的。
本文将 attention 分解为两个组成部分:
- Temporal Attention:每个视角内部独立执行,token 通过 KV Cache(causal)关注此前帧中的 token,从而捕捉运动动态并维持时间一致性。
- Cross-view Attention:每个时间步上跨不同视角执行。来自不同视角的 token 相互关注,使模型能够对共享场景元素(例如几何结构、物体位置和运动)形成一致的表示。
这个设计让复杂度从 O(N2T2) 降低到 O(NT2)+O(TN2),实际最多支持 7 个同步视角。架构图大概这样子:
训练
整体看起来还是比较复杂的,不是算法层面的复杂,而是场景任务适配方面比较复杂。训练包括三个阶段:
- 垂直领域场景迁移。LLM 很多任务可以不迁移,但多模态这边还不行,训练时没见过,推理时完犊子。
- Cross-view Attention 适配。使模型适应双向多视角(有些视角很不常见)生成,这个只针对多视角模型。每个 block 都注入这个视角(view)embedding,和 timestep embedding 的注入类似。零初始化,确保收敛稳定。这里后面后训练加入基于世界场景地图控制的可控生成能力后,成为 teacher 模型。
- 自回归适配。主要是 Causal Masking(用了 Flex-Attention)和 Diffusion Forcing(独立采样每一帧的时间步),让模型能自回归生成。这里 Diffusion Forcing 是把自回归序列建模和扩散去噪训练结合起来,让序列中的每一帧都可以处于不同的去噪阶段,同时保持因果依赖关系。后面也是后训练加入基于世界场景地图控制的可控生成能力。
最后是 Self Forcing DMD(Distribution Matching Distillation)蒸馏阶段,实现少步生成,同时缓解自回归生成过程中误差累积问题。
- Self Forcing:
- 训练时不再使用 GT 作为历史帧,而是使用模型自己生成的帧。解决了标准方法训推不一致导致的 Exposure Bias 问题。
- 每帧只经过两步扩散去噪生成,而不是完整的 T 步扩散过程。
- 每次迭代只对一个随机去噪步骤计算梯度,跨迭代覆盖所有步骤,降低计算开销。
- 历史帧只作为当前帧的条件,不对历史帧反向传播梯度。引入了真实偏差,但不做反向传播计算。
- 限制历史上下文窗口大小(滑动窗口 L 帧),避免随着视频长度增长,Attention 计算成本持续增加。
- DMD(下式):
- 不是逐像素重建,而是整体视频级分布匹配目标。具体来说,是最小化模型自回滚视频与真实视频经过相同加噪过程后的分布之间的反向 KL,即 Et[DKL(pθ,t∥pdata,t)]。反向 KL 是蒸馏常用配置了,我们在《LLM 强化的“炼金术”:主流开源模型的 RL 优化策略赏析 | 长琴》提到过,反向 KL 倾向于 Mode Seeking,而正向 KL 则倾向于 Mode Covering。
- x^ 是模型通过自回滚生成的视频片段,fϕ 是冻结的真实数据 Score Network,fψ 是可训练的虚假数据 Score Network,Score 差值 fψ−fϕ 提供了一个梯度信号,引导生成器在完整视频序列的分布层面向真实数据流形靠近,而不需要配对数据,或逐像素监督。
LDMD(θ)=E[21∥x^−sg[x^−(fψ(x^t,t)−fϕ(x^t,t))]∥2](1)
伪目标构造
这里有个问题,fψ−fϕ 为什么恰好能提供让生成分布靠近真实分布的梯度?其实,这个 Loss 本身的设计也很有意思,它可以简写成:
x^−(x^−d)=d(2)
为啥要这么设计呢?为啥不能直接用 d 呢?我们来看看,这其实是一个非常优雅的梯度工程——先推导出要的梯度,再构造一个 Loss,让自动求导产生这个梯度。也就是说,人为构造一个梯度恰好等于 d 的代理 Loss。
L=21∥x^−sg[x^−d]∥2(3)
我们把 Loss 拆成两部分:
- 左边的 x^,正常参与梯度传播。
- 右边的表达式,停止梯度传播。
前向计算时,
x^−sg[x^−d]=x^−(x^−d)=d(4)
Loss 其实就是(数值计算等价):
L=21∥d∥2(5)
但反向时就不一样了。SG 有两个特点,sg(a)=a,∂a∂sg(a)=0。对 Loss 求 x^ 的梯度:
∇x^L=∇x^21∥x^−sg[x^−d]∥2=x^−sg[x^−d]=d(6)
右边在反向传播时就是一个常数:∂x^∂sg[x^−d]=0。
这意味着,虽然表面上我们在做 MSE,但实际上我们获得了一个人为指定的梯度(d)。
往回说,如果已经得到了一个理想的梯度 g(x^)=d,我们希望生成器沿着这个梯度更新:
x^new=x^−ηd(7)
怎么构造一个 Loss,让它对 x^ 求导之后恰好等于 d 呢?最 naive 的方法就是构造一个伪目标:
x^target=x^−d(8)
然后让当前生成结果回归这个目标:
L=21∥x^−x^target∥2(9)
但如果直接使用这个目标的话,反向传播会穿过 x^target,梯度不是我们希望的 d,所以就加上 SG。
L=21∥x^−sg[x^−d]∥2(10)
这就回到了式(3)。
还有一个小问题,为什么不直接写成 21∥d∥2 呢?我们试一下,把 Loss 写成这样:
L′=21∥d(x^)∥2(11)
求导后成这样了:
∇x^L′=Jd(x^)⊤d(12)
Jd 是 d 对 x^ 的 Jacobian,不是我们想要的 ∇x^L=d。
这里主要是,我们并不希望优化器去改变 Score Difference 本身,而是希望把 Score Difference 当作一个已经计算好的梯度信号,直接作用到生成样本上。
其实,还有一个小问题,如果希望把 d 作为梯度信号,完全可以直接这样:
Llinear=sg[d]⊤x^(13)
这简单线性函数梯度效果其实一样的,那为什么 DMD 使用 MSE 形式呢?感觉应该是 MSE 形式上可能更加直观?它把梯度信号解释为一个伪目标,Loss 数值非负,形式上也更容易理解为回归。
为啥d能提供梯度
好吧,我真是啰嗦,绕的有点远了,现在回到前面那个问题,fψ−fϕ 这个 d 为什么恰好能提供让生成分布靠近真实分布的梯度,凭什么呢?我们从高斯分布开始,假设一维高斯分布:
p(x)=N(μ,σ2)(14)
对数概率密度为:
logp(x)=−2σ2(x−μ)2+C(15)
求导:
∇xlogp(x)=−σ2x−μ=σ2μ−x(16)
我们把这个梯度定义为 Score,它就像一个指向概率密度高处的力场。x>μ,Score 为负,应该向左移动;反之应该向右移动。两个 Score 相减意味着什么?
我们假设真实数据分布 pdata 是一个高斯分布,均值为 0,生成分布 pθ 也是一个高斯分布,均值为 4,两者方差都为 1。它们的 Score 分别是:sdata(x)=−x 和 sθ(x)=4−x,两个 Score 相减,得到一个正数 4。
如果我们按照梯度下降更新生成样本:
xnew=x−ηd(x)(17)
其实就是:
xnew=x−4η(18)
生成样本就会整体向左移动,而左边恰好是真实分布的均值!
这就是 Score Difference 的意义:Fake Score 告诉我们,生成分布自身希望样本往哪里移动;Real Score 告诉我们,真实分布希望样本往哪里移动。两者相减,其实就是生成分布相对于真实分布需要修正的方向。
现在我们把它推广到 KL,
DKL(pθ∥pdata)=Ex∼pθ[logpθ(x)−logpdata(x)](19)
求导(过程见附录):
∇θDKL=Ez[(∂θ∂Gθ(z))⊤(∇xlogpθ(x)−∇xlogpdata(x))]=Ez[(∂θ∂Gθ(z))⊤(sθ(x)−sdata(x))](20)
其中,Gθ 就是视频生成模型,z 是生成过程中的随机噪声。
现实中我们无法直接计算 ∇xlogpθ(x) 和 ∇xlogpdata(x),我们甚至不知道 pθ(x) 和 pdata(x) 的显式概率密度函数。
所以 DMD 改为匹配加噪后的分布。设 x^t=αtx^+σtϵ,将式(20)应用于加噪后的 KL,再通过加噪过程求导,作用到干净输出 x^ 上的梯度信号为 d=αt(sθ,t(x^t)−sdata,t(x^t))。本文采用 αt=1−t,这里没有时间权重,式(1)其实是省略了尺度系数。
两个网络分别估计加噪后分布的 Score:
| 网络 |
学习目标 |
作用 |
| fψ |
生成数据分布 |
Fake Score |
| fϕ |
真实数据分布 |
Real Score |
其中,fϕ 是冻结的,提供真实数据分布的参照,fψ 是持续训练的,让它能够跟上生成器当前产生的数据分布。也就是说,生成器和 Fake Score Network 是交替更新的。
好的,两个东西现在应该闭环了,还是蛮有意思的。
推理优化
主要看看模型方面。
第一个是局部时间注意力:
- 单视角:窗口大小为 6 个 latent frames(对应 24 个 RGB frames)。
- 多时间:窗口大小为 8 个 latent frames(对应 32 个 RGB frames)。
第二个是流式固定 shape KV Cache:
- 预先分配固定大小的 KV Cache,并在整个 rollout 过程中保持其张量形状不变。
- Cache 更新操作放到独立线程中执行,主线程不必等待 Cache 更新。
第三个是编译与 CUDA Graph:
- 因为 KV Cache 已经根据固定大小的局部注意力窗口进行了预分配,前向计算始终运行在具有相同静态形状的张量上。
torch.compile 编译并将计算过程捕获为 CUDA Graph,lazy 机制(第一个 chunk 执行时完成捕获)。
第四个是轻量级编解码器:
- 单视角:VAE 替换为 LightX2V 的 LightVAE 或 LightTAE。
- 多视角:采用 Pixel Shuffle 技术替代 LightVAE,以进一步提升模型速度。
- 两个视角均使用 LightTAE 将去噪后的 latent 解码回 RGB 空间
第五个是将与去噪步无关的算子移出循环:
- RoPE 频率计算:每个去噪步骤中 Self-Attention 使用相同的 RoPE 频率,因此只需在每个 chunk 开始时计算一次即可。
- Patchify 和 Unpatchify 操作:分别负责将 latent 转换为 DiT 使用的 Token 布局,以及将 Token 布局还原为 latent。由于只依赖于 chunk 的形状,所以将 Patchify 放在 chunk 生成开始时执行,将 Unpatchify 放在 chunk 生成结束时执行,而不是在每次进入和退出 DiT 时重复执行。
都是推理优化的一些小细节。
除了模型方面,还有多 GPU 推理(主要是 16-GPU 四视角配置),沿着 DiT 的三个并行维度:
- 视角维度 V:4 个 rank 可以接近线性加速,达到 4 时这个维度就到上限了。
- 时间维度 T:下一个维度,每个 chunk 包含 4 个 latent frames(1 个 对应 4 个 RGB frames),这里也是 4 个 rank。
- 空间维度 HW:超过 16 GPU 才会切分,否则就是 1。
上下文并行中的 Attention 计算采用 Ring Attention,将 KV 分片传输与本地 Attention 计算重叠执行,来隐藏通信开销。这里 Ring Attention 的实现应该会采取 Online Softmax 一类的算法来分块增量计算,我们在《从 FlashAttention 到 Streaming Reduction:如何把“全局算子”改写成可分块计算 | 长琴》介绍过。
最后值得一提的是,这些优化方案都直接开源了:NVIDIA/flashdreams: high-performance inference and serving library for interactive autoregressive video and world models,而且它还是个端到端的 server 框架,提供基于 gRPC 和 WebRTC 的服务器/客户端通信协议。
其他
其实后面还有不少内容,比如第 7 节,把 OmniDreams 改造成 World-Action Model(WAM),前面的模型是根据动作生成画面,WAM 则利用它学到的场景表示,根据视觉观测和历史运动,直接预测车辆未来的轨迹。再比如第 8 节,把 OmniDreams 改造成画面修复器(Diffusion Fixer),修复有缺陷的渲染画面。
同一个世界模型骨干,既能迁移成驾驶策略,也能用于修复传统仿真器的画面,表现出了很强的跨任务迁移能力。
OmniDreams 把数据整理、场景控制、自回归训练、蒸馏和推理优化串成了一个完整的闭环仿真方案,非常值得作为完整项目参考。不过,对我个人来说,最有意思的还是 Self Forcing 和 DMD:让模型在自己生成的历史上训练,再用分布级目标提供监督。
总之,虽然文章是自动驾驶的,但这种从训练到实际交互的做法,其他需要实时生成观测的场景也可以借鉴。
附录:KL求导
参数 θ 包含很多个分量。下面先只改变第 j 个参数 θj,其他参数保持不变,最后再把各个参数的求导结果合起来。
反向 KL 定义如下:
DKL(pθ∥pdata)=∫pθ(x)logpdata(x)pθ(x)dx(A.1)
对 θj 求导,使用乘积法则:
∂θj∂DKL=∫∂θj∂pθ(x)logpdata(x)pθ(x)dx+∫pθ(x)∂θj∂logpdata(x)pθ(x)dx(A.2)
注意,pdata 与 θj 无关,因此有:
∂θj∂logpdata(x)pθ(x)=pθ(x)1∂θj∂pθ(x)(A.3)
代回去,有:
∂θj∂DKL==∫∂θj∂pθ(x)logpdata(x)pθ(x)dx+∫∂θj∂pθ(x)dx∫∂θj∂pθ(x)(logpdata(x)pθ(x)+1)dx(A.4)
我们已知:
x=Gθ(z),z∼p(z)(A.5)
其中,噪声 z 的分布与参数 θ 无关。
只改变参数 θj 时,一个生成样本的变化速度是 ∂Gθ(z)/∂θj。不同的 z 可能生成同一个 x,所以对这些样本的速度取条件平均,定义:
vj(x)=Ez∣Gθ(z)=x[∂θj∂Gθ(z)](A.6)
这里的 vj(x) 就表示:只改变第 j 个参数时,位于 x 处的样本平均往哪里移动、移动多快。
样本移动会引起生成分布 pθ(x) 的变化,两者通过连续性方程联系起来:
∂θj∂pθ(x)=−∇x⋅(pθ(x)vj(x))(A.7)
简单来说,样本流入某个区域,会使那里的概率增加;流出则使概率减少。将连续性方程代入式(A.4),得到:
∂θj∂DKL=−∫∇x⋅(pθvj)(logpdatapθ+1)dx(A.8)
假设相关密度与映射足够光滑,可以交换求导与积分,且分部积分的边界项消失。利用公式:
−∫(∇x⋅A)fdx=∫A⊤∇xfdx
可得:
∂θj∂DKL===∫(pθ(x)vj(x))⊤∇x(logpdata(x)pθ(x)+1)dx∫pθ(x)vj(x)⊤∇xlogpdata(x)pθ(x)dx∫pθ(x)vj(x)⊤(∇xlogpθ(x)−∇xlogpdata(x))dx(A.9)
写成期望形式,并用 sθ、sdata 表示两个分布的 Score:
∂θj∂DKL=Ex∼pθ[vj(x)⊤(sθ(x)−sdata(x))](A.10)
代入 vj(x) 的定义:先对生成同一个 x 的噪声取平均,再对所有 x 取平均,等价于直接对生成噪声 z 取平均。因此:
∂θj∂DKL=Ez[(∂θj∂Gθ(z))⊤(sθ(x)−sdata(x))],x=Gθ(z)(A.11)
上式是对单个参数 θj 的求导结果。把所有参数的结果按顺序合起来,就得到完整梯度:
∇θDKL=Ez[(∂θ∂Gθ(z))⊤(sθ(x)−sdata(x))],x=Gθ(z)(A.12)
这就是式(20)。