OPD 大家熟知是需要一个 teacher 提供 logits 的,OPSD(自蒸馏)一般是拿一个外部信号让模型自己提升,都是现在的主流范式。我们前阵子介绍的《「差值即信号」:OPD 蒸馏的新范式 | 长琴[1]》在 OPD 这个方向上更进一步——不是直接学教师,而是学教师在不同情况下的「差异」,类似于学这种「能力」。我们把这种差值简称为 diff。
Diff 出现后,一个很自然的问题就来了——teacher 不一定再需要一个更大更强的模型,只要能提供 diff 那就是 teacher。这就是前文提到的 W2S(weak to strong)OPD,weak 模型便宜好训,可以训练一大堆不同方向的,然后 diff 一股脑儿给 student。
但是这里怎么给还是有蛮多做法的,这就引出了现在大家正在看的这篇文章。
直观框架
我们压根不看任何论文,就直接来看这个 diff 能怎么用。
- 第一级,diff 重新锚定到某个 target policy,重构出目标分布。
- 第二级,diff 作为隐式 reward,这思想很 DPO 了。
- 第三级,diff 对梯度分量施加方向相关的缩放,重塑梯度几何。
值得一提的是,方案本身并不挑模型,无论你是离散的 causal LM,还是连续的 diffusion,都可以用。本文主要聚焦离散 token policy。
Diff to Target
先回顾一下 OPD,看看基本流程:
- Student 自己 rollout,也就是 on-policy。
- 每个 token 构造一个目标分布,diff 这一步进,diff 自然来自 teacher。
- Student 最小化自己分布和目标分布,KL 或 MSE。
这里的 diff 就来源于上一篇文章[2]介绍的各种方法,这里不再赘述。特别值得一说的是 VAD,为啥呢?因为 VAD 进一步做了一件事——把 teacher 投影到 diff 中与目标相关的方向(u_t)上,这里重构出来的分布才是 student 真正要学的分布。
这里多出来的就是 diff 后那个“方向”,也就是说,只想要那个干净方向,加上 base 就是重构的目标。所以说它比直接 diff 更进了一步。别急,我们后面还会提到它。
Diff to Reward
其实最简单的方案就是直接拿 teacher 的 logprob 作为 reward,不过那是 OPD 的思路,这次我们只说 diff,请看来自清华×字节的《2607 Weak-to-Strong Generalization via Direct On-Policy Distillation[3]》,简称 Direct-OPD。出发点很简单,咱们前面提到过—— weak to strong。做法也很直观:直接计算 RL 前后的 log 比,将其作为隐式奖励。这里 transfer 的是 RL 的“提升”,而非 weak 模型。
Weak(teacher)模型的 diff 定义如下:
ΔT(y∣x)=logπT(y∣x)−logπTref(y∣x)(1)
这个 diff 在数学上等价于一个 rm,针对 ∆T 进行优化和针对该 rm 进行优化目标函数形式相同,证明过程参见附录 A,最终我们有:
ΔT(y∣x)=β1rT(x,y)−logZT(x)(2)
序列级目标函数就变成:
JDirect-OPD(θ)=Ex∼D[Ey∼πθ(⋅∣x)[ΔT(y∣x)]−αDKL(πθ(⋅∣x)∥πS(⋅∣x))](3)
根据附录 A 式(7),我们知道 π∗∝πrefexp(r/β),于是上式有最优解:
π∗(y∣x)∝πS(y∣x)exp(α1ΔT(y∣x))=πS(y∣x)(πTref(y∣x)πT(y∣x))1/α(4)
注意,式(2)有个 β,所以这里用 α。学生模型的优化过程相当于用小教师模型的隐式奖励进行 KL 正则强化,同时以自身初始化策略 πS 为参考。啊,简单来说就是带 KL 的 REINFORCE,后者我们在《Reinforce++和它的KL Loss选择 | 长琴[4]》 介绍过。
奖励当然也可以分解为 token 粒度,那就变成了 token 级别的 reward(论文实际没用折扣因子):
rt(v)=logπT(v∣st)−logπTref(v∣st)(5)
为了将信号集中在学生模型的 action 空间,这里将其限制在学生模型的 top-k 集合,并在该集合内重新归一化。
pˉt(v)=∑u∈Stπθ(u∣st)πθ(v∣st),v∈St=TopKvπθ(v∣st)(6)
最终梯度为:
∇θJDirect-OPD≈Ex∼D,y∼πθt∑v∈St∑sgweightpˉt(v)rewardrt(v)∇θlog-likelihoodlogπθ(v∣st)−α∇θDKL(πθ(⋅∣x)∥πS(⋅∣x))(7)
这里为了防止按 token 导致的方差太大,将每一步的单 token 估计替换为在受限分布 pˉt 上对其求期望。这个操作叫 Rao–Blackwell 化,简单来说就是:如果你已经知道了一部分随机变量的完整分布,就不要再对这一部分进行随机采样,而是直接对它求条件期望。
我们和标准的 REINFORCE 对照看一下就明白了,
t∑rt(vt)∇logπ(vt∣st)(8)
这里每个 t 只采样一个 vt,但是 Direct-OPD 是对当前位置的 action(Top-K)求期望:
t∑对当前位置的 action 求期望v∈St∑pˉt(v)rt(v)∇logπ(v∣st)(9)
换成自然语言描述就是:我先随机走完轨迹,然后对于每个 prefix,不再随机抽下一个 token,而是把 student 最可能的 top-k 个 token 的 policy-gradient contribution 全部按概率加权平均。
到这里,我们可能有疑惑了,为啥 REINFORCE 不用 Rao-Blackwell 呢?其实这个和算法没关系,一般 RL 算法通常不知道或不方便知道“每个 action 的 reward”,action space 可能非常大,policy 往往需要真的执行一步 action 才能知道 reward,但你不能说我把所有可能的 action 都执行一遍,所以往往就只能采样。
Direct-OPD 这里是直接用 top-k action 去计算了——在 teacher 的角度直接把 reward 告诉 student。另外 RL 的 reward 往往是轨迹出来才知道,论文这里也做了简化,实际没有使用折扣因子,我们在式(5)那里提过。
除了 r 的问题,Direct-OPD 还有一个比较棘手的 β 和 α,它们的尺度并不一致,β 是 teacher 的系数,α 则是 student 的系数。我们看式(4),α 相当于对 πS 进行指数倾斜时的温度参数,它只有相对于 ΔT 的尺度而言才具有意义,但 ΔT 使用的是教师 reward 的单位,两个参数不存在自然换算关系。对于不同的 teacher-student pair,没有一个固定的 α,论文这里采用了一个轻量级的 controller,根据 dense signal 的运行尺度动态调整 α。
设 αm 为训练迭代 m 时的 KL 系数,设 rˉm 为 batch-level mean,α 更新规则为:
αm+1=clip(αm(1+ϵsgn(rˉm)),αmin,αmax),(10)
其中,sgn(0) = 0,ε 默认为 0.01,[αmin, αmax] = [0.5, 2.5],sgn(rˉm) 表示,在 student 当前访问到的 prefixes 时,teacher 的 RL 究竟提高还是降低了这些被保留的候选 token 的概率。这个 controller 的目的,是让 dense signal 保持在一个相对平衡的状态:当 teacher 当前给 student 访问到的 token 整体加分太多时,加大 KL anchor,别让这个 signal 把 policy 推得太猛;当 teacher 整体在减分时则减小 KL anchor,让 student 更容易跟着 teacher 的负向变化走。
简单的想法,复杂的设计——看算法还是得看细节,真的一大堆。最后还有一点值得提一下,teacher 必须是先跑过 RLVR 的 post-RL checkpoint,所以 verifier 并没消失,是冻结在了 teacher 上游、后面经由 diff 二手带过来的。另外,teacher 和 student 不必须同 tokenizer,但需有可对齐的 token 空间。
Diff to Gradient
我们知道 teacher 的 logprob 是可以直接作为训练的 dense reward 的,这其实和 OPD 都没关系。不过 OPD 本身其实也可以反过来利用 reward,比如《2607 Reward-Gated On-Policy Distillation[5]》,就是只保留 reward 和 teacher-student 似然差一致的轨迹,它不假设 teacher 永远正确,损失函数如下:
LRG-OPD=∑igi∑tmt(i)∑igi∑tmt(i)KL(πθ(⋅∣st(i))∥πT(⋅∣st(i))),(11)
其中,
gi=1[(Ai>0∧LT(i)>LS(i)+δ)∨(Ai≤0∧LT(i)<LS(i)−δ)],(12)
这里其实就是根据 advantage 和 teacher-student 似然差过滤轨迹,后面的还是 OPD。
回到咱们的主题 diff,这里说的是 diff 是 loss 权重,其实刚刚的也算是一个例子,只不过权重是 1/0(同时利用了 reward)。如果我们稍微调整一下视角——student 依然是常规的 RL 得到梯度,但是 diff 作为一个 shift 影响这个梯度——和刚刚的过滤有点像,但是看起来已经不是 OPD 了,不过这个问题不大,实践时很多算法都是混在一起用的,这不是重点。
来自《2609 Eliciting Weak-to-Strong Generalization with On-Policy Reverse Distillation[6]》的 OPRD(On-Policy Reverse Distillation)就是这么做的,它在 student 的同策略轨迹上,计算验证器引导的策略梯度,并提取弱 teacher 相对其参考策略的偏移,然后把 student 梯度投影到这个方向上,并放大投影分量,同时保留正交分量不变。
当 teacher 的转移方向与 student 的梯度方向一致时,OPRD 会强化这一共同方向,加速收敛;而当两者方向相悖时,OPRD 会在验证器的支持下强化 student 出 Teacher 意料的行为,从而使其能够超越 teacher,取得进一步的提升。看起来是不是比刚刚的 gate 版本更进一步了,我们来看看具体怎么做的。
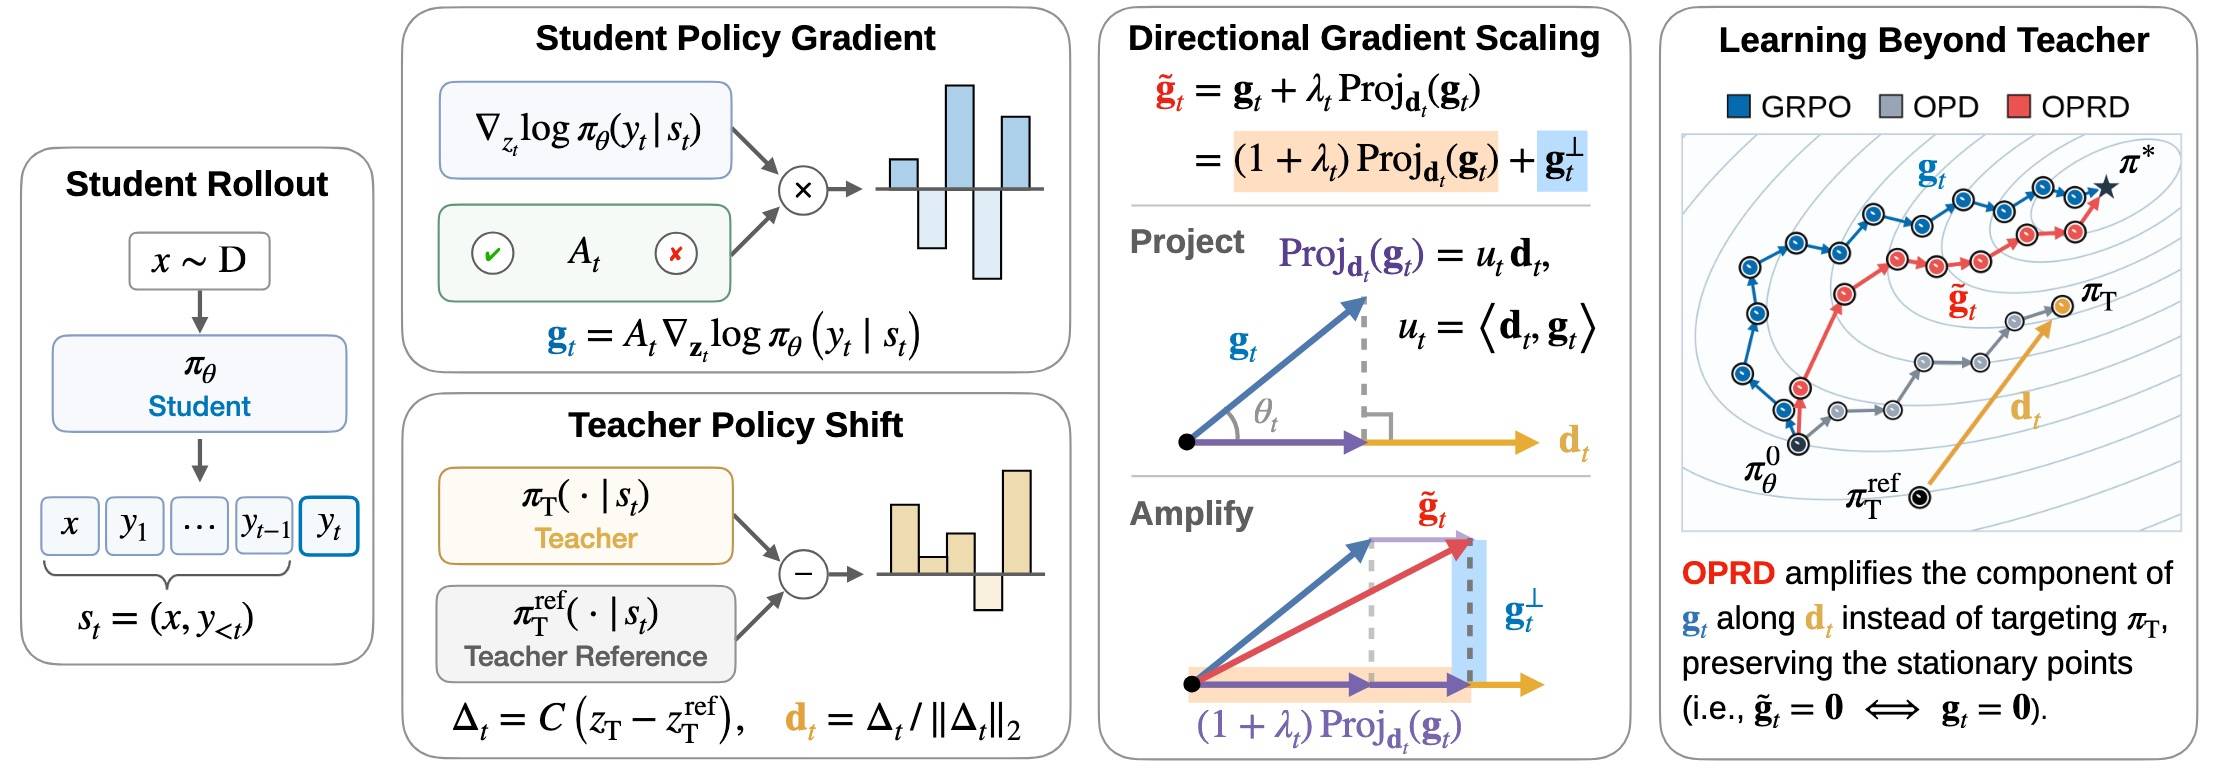
如图,dt 就是要投影的单位方向。
Δt:=C(zT(st)−zTref(st))=C(logπT(⋅∣st)−logπTref(⋅∣st)),(13)
从直觉上看,Δt 捕捉了后训练所引发的 teacher 在下一 token 相对偏好上的变化,并且未中心化的 log-policy ratio 蕴含着一种隐式奖励。我们从 Direct-OPD 过来的,这里不需要展开。又因为是弱 teacher,这种 shift 不一定能提高 student reward,所以 OPRD 使用了单位方向进行梯度缩放。
gt:=gt+λtProjdt(gt)=amplified(1+λt)Projdt(gt)+unchangedgt⊥,(14)
这里,student 的策略梯度被分解为向 teacher 指导方向的投影分量和一个和 teacher 优化方向不相关的正交分量:gt⊥=gt−Projdt(gt),仅对投影分量按 1 + λt 的比例进行放大(既能同向也能反向),保持正交分量不变(student 基于 verifier 独自探索出来的全新领域)。
Teacher shift 和 reward(student)一致时,放大梯度,不一致时(这时候 teacher 可能是错的),放大 student 背离 teacher 的力度。具体来说,当 ut<0 时,投影分量 Projdt(gt)=utdt 指向 −dt,代表 student 梯度中“反对 teacher”的那部分分量。当 λt>0 时, g~t 实际上等于放大了 student 梯度中“反对 teacher”的那部分分量!只要这个背离方向得到了验证器(reward)的支持,student 就能更快地摆脱 teacher 的错误引导。
另外,考虑到训练初期自身 reward 梯度可能有噪声,论文设计了一个渐进激活机制——当早期 student 与 teacher 相悖时,即使 teacher 可能是错的,算法也不剧烈反驳(保持训练稳定),而是让 student 按照自己的标准 RL 梯度慢慢探索;中后期如果验证器 reward 支持 student,而 teacher 方向依然相悖,就全力放大 student 背离 teacher 的梯度,帮助其快速打破束缚。
OPRD 之所以能让 student 超越弱 teacher 的上限,归根结底是:只给 student 加速,而不给它设限。它对梯度的修改方式可以看作对原梯度乘以一个线性变换矩阵 g~t=(I+λtdtdt⊤)gt(推导见附录 B)。这个矩阵是可逆且正定的(只要 λt≥0),意味着:
g~t=0⟺gt=0,(15)
也就是说,只有当 student 的验证器梯度变成 0 时,更新才会停止,它最终的目标依然是 reward 最大化,它不会引入新的驻点,也不会消除原有驻点,变换前后的停止点集合相同。OPRD 只是给 student 的探索提供了一个非负的加速度,让收敛更快,但不破坏 student 原来的优化方向(即仍然保持为 verifier 目标的上升方向)。
看起来好像 teacher 没啥用,只是提供了个加速度,但这里不能这样看。Teacher 在这里不仅能够提高训练效率(尤其是 GRPO 的稀疏信号场景),更是可以帮助 student 更快穿过平坦或弱梯度区域,并改变最终进入的吸引域,从而在有限的预算下达到更好的效果。非常 nice 的设计。
投影视角
从 VAD 到 OPRD,都不约而同地做了同一件事——diff 方向投影,虽然它们投影的对象和落点不同,VAD 投影 teacher 校正,为了重构蒸馏目标;而 OPRD 投影 student 梯度,为了缩放 verifier 梯度中与 teacher 对齐的分量。前者在蒸馏,后者其实是 RL。
为什么我们单独把投影拿出来说?一方面是 OPD 已经越来越细了,像 diff 这种策略肯定会越来越成熟,这里可挖的东西还不少;另一方面,直觉来看 diff 比直接学 teacher 更合理,更容易和 RL 结合起来,尤其在现在 MOPD 大行其道的背景下,diff 给了很好的切入点,一定程度上来说,它比 RM 更适合作为 RM。
好了,言归正传,不知道大家有没有感觉,OPRD 只把 diff 用到缩放上,感觉本质还是 RL,有点保守,或者说少了 OPD 的感觉;而 Direct-OPD 又有点过头,diff 决定了所有。其实,我感觉我们更想要的是一个中间感觉——diff 直接进到 reward/advantage,成为 RL 的一个独立反馈源。
这个 idea 不新鲜,我盲猜肯定有人做过,派出我的 agent 搜一圈看看!哦吼,简直不要太多,diff 作为 dense reward 这个 idea 实在是太容易想到了,而且已经做得非常细了。比如《2602 Learning beyond Teacher: Generalized On-Policy Distillation with Reward Extrapolation[7]》,《2607 On-Policy Delta Distillation[8]》,尤其是第二篇,那 delta 可不就是 diff 嘛,第一篇直接从理论上证明了 OPD是稠密 KL 约束 RL 的一个特例,其中奖励函数和 KL 正则化项的权重始终相等,且参考模型可以是任意模型。还有一些相关 paper 就不一一列举了,总之已经红的不成样子了!
但是,把 diff 投影作为 dense reward 暂时还没有找到直接的做法,但是稍等,投影后的方向向量要怎么变成 reward 呢?也就是说,这个向量得映射成为一个标量的 reward 值,这里还是有一些文章可以做的。也许 work,也许只是臆想,待我做一些实验后额外补充,而且这里看起来更适合 multi,正好下篇来讲讲 MOPD,感觉很多做法,值得梳理一下。
小结
本文从 OPD 自然而然的 diff 出发,直接给出了三种 diff 的用法,从 target 到 reward 再到 gradient,diff 从 OPD 走到 RL;同时,我们还有另一条投影的暗线,diff 的单位方向,进一步探讨发现,虽然 diff 相关的研究很多,但投影作为 reward 貌似值得一试,且等实验结果。
附录A:证明Diff=RM
给定 RL 的目标函数:
πθmaxE(x,y)∼πθ[r(x,y)]−βDKL(πθ(y∣x)∥πref(y∣x))(A.1)
可以写成:
πθmaxE(x,y)∼πθ[r(x,y)−βlog(πref(y∣x)πθ(y∣x))](A.2)
除以 β 变形:
πθmaxE(x,y)∼πθ[loger(x,y)/β−log(πref(y∣x)πθ(y∣x))]=πθmaxE(x,y)∼πθ[log(πθ(y∣x)er(x,y)/β⋅πref(y∣x))](A.3)
现在再把目标写回 KL 形式,其实就是对“变歪的分子”重新归一化,我们假定分子和为 Z,于是有:
πθmaxE(x,y)∼πθ[log(πθ(y∣x)er(x,y)/β⋅πref(y∣x)/Z)](A.4)
只差一个不影响 argmax 的常数 logZ,除以 Z 后分子才是概率分布。其中:
Z(x)=y∑πref(y∣x)⋅er(x,y)/β(A.5)
为啥非要凑一个 KL 形式呢?因为 KL(P ‖ Q) ≥ 0,而且只有当 P 和 Q 完全相等时才 = 0,所以只要我们把目标写成「−KL(πθ ‖ 某个分布) + 常数」的形式, −KL 最大 = KL 最小 = 0,而 KL=0 只可能是 πθ = 那个分布,我们就得到了想要的分布。
式(4)就是 −KL(πθ ‖ 某个分布) ,它本来就等价于 KL 最小,即 KL=0。也就是说,当我们找到那个最优分布时,有:
E(x,y)∼πθ[log(er(x,y)/β⋅πref(y∣x)/Zπθ(y∣x))]=0(A.6)
于是,KL(πθ∥π∗)=0⟹πθ(y)=π∗(y),我们有:
π(y∣x)=π∗(y∣x)=er(x,y)/β⋅πref(y∣x)/Z(A.7)
即:
logπref(y∣x)π∗(y∣x)=βr(x,y)−logZ(A.8)
由于 log Z(x) 在同一 prompt 下的所有回答中为常数,因此策略与参考的 log 比值可以恢复奖励信息,仅相差一个正的缩放因子 β 和一个与提示相关的常数。
这正是直接 DPO 所基于的恒等关系——DPO 在无需单独训练 rm 的情况下,根据偏好数据直接优化策略。我们在《从 SVM 到分布对齐:后训练方法的另一个统一视角 | 长琴[9]》有过介绍。
本文是把 DPO 的过程反过来用:我们已经获得了 RL 训练后的策略 π 及训练前的参考策略 πref ,然后通过两者的策略比值反向读出这个奖励信号。
附录B:OPRD梯度线性变换
因为:
Projdt(gt)=utdt=(dt⊤gt)dt,(B.1)
所以:
g~t=gt+λtProjdt(gt)=gt+λt(dt⊤gt)dt,(B.2)
注意到 (dt⊤gt) 是标量,有:
(dt⊤gt)dt=dt(dt⊤gt)=(dtdt⊤)gt,(B.3)
所以有:
g~t=(I+λtdtdt⊤)gt.(B.4)
为什么这个矩阵是“可逆且正定”的呢?我们令 M=I+λtdtdt⊤,来分析它的特征值。
沿 dt 方向:
Mdt=(I+λtdtdt⊤)dt=dt+λtdt(dt⊤dt)=(1+λt)dt,(B.5)
特征值是 1+λt。注意这里 dt 是单位向量,所以 dt⊤dt=∥dt∥22=1。
沿着与 dt 正交的任何方向 v(满足 dt⊤v=0),有:
Mv=(I+λtdtdt⊤)v=v+λtdt(dt⊤v)=v,(B.6)
特征值是 1。
只要 λt≥0,所有特征值满足严格大于 0,所以是正定矩阵,行列式不为零,所以是可逆矩阵。
Reference
[1] 「差值即信号」:OPD 蒸馏的新范式 | 长琴: https://yam.gift/2026/08/11/NLP/LLM-Training/2026-08-11-OPD-Diff-is-Signal/
[2] 上一篇文章: https://yam.gift/2026/08/11/NLP/LLM-Training/2026-08-11-OPD-Diff-is-Signal/
[3] 2607 Weak-to-Strong Generalization via Direct On-Policy Distillation: https://arxiv.org/abs/2607.05394v2
[4] Reinforce++和它的KL Loss选择 | 长琴: https://yam.gift/2025/10/24/NLP/LLM-Training/2025-10-24-ReinforcePP/
[5] 2607 Reward-Gated On-Policy Distillation: https://arxiv.org/abs/2607.04037v1
[6] 2609 Eliciting Weak-to-Strong Generalization with On-Policy Reverse Distillation: https://arxiv.org/abs/2609.08798v1
[7] 2602 Learning beyond Teacher: Generalized On-Policy Distillation with Reward Extrapolation: https://arxiv.org/abs/2602.12125
[8] 2607 On-Policy Delta Distillation: https://arxiv.org/abs/2607.15161
[9] 从 SVM 到分布对齐:后训练方法的另一个统一视角 | 长琴: https://yam.gift/2026/07/04/NLP/LLM-Training/2026-07-04-SVM-to-Alignment/