本文记录一次线上服务关于 FD 泄露的 Bug 排查经历。相关代码:hscspring/fd_leak: fd leak caused by monkey patch.[1]
引子:线上服务频频告警,一切迹象都指向了再常见不过的 FD 耗尽问题。然而,这次的排查之旅却像一场侦探游戏,线索若隐若现,真相几度反转。最终,我们揪出的元凶竟是一个“躲在暗处”的猴子补丁(Monkey Patch),而触发它作案的,则是一两行看似人畜无害的导入语句。
本文记录一次线上服务关于 FD 泄露的 Bug 排查经历。相关代码:hscspring/fd_leak: fd leak caused by monkey patch.[1]
引子:线上服务频频告警,一切迹象都指向了再常见不过的 FD 耗尽问题。然而,这次的排查之旅却像一场侦探游戏,线索若隐若现,真相几度反转。最终,我们揪出的元凶竟是一个“躲在暗处”的猴子补丁(Monkey Patch),而触发它作案的,则是一两行看似人畜无害的导入语句。
之前在 解锁模型潜能:Reward 数据如何塑造与激发 LLM 的推理策略 | Yam[1] 中,我们在介绍论文 Spurious Rewards 时提过:“关于GRPO 截断那部分推导和进一步分析也不错,有时间单独择文再议”。本文就来聊聊 GRPO 中的 clip。
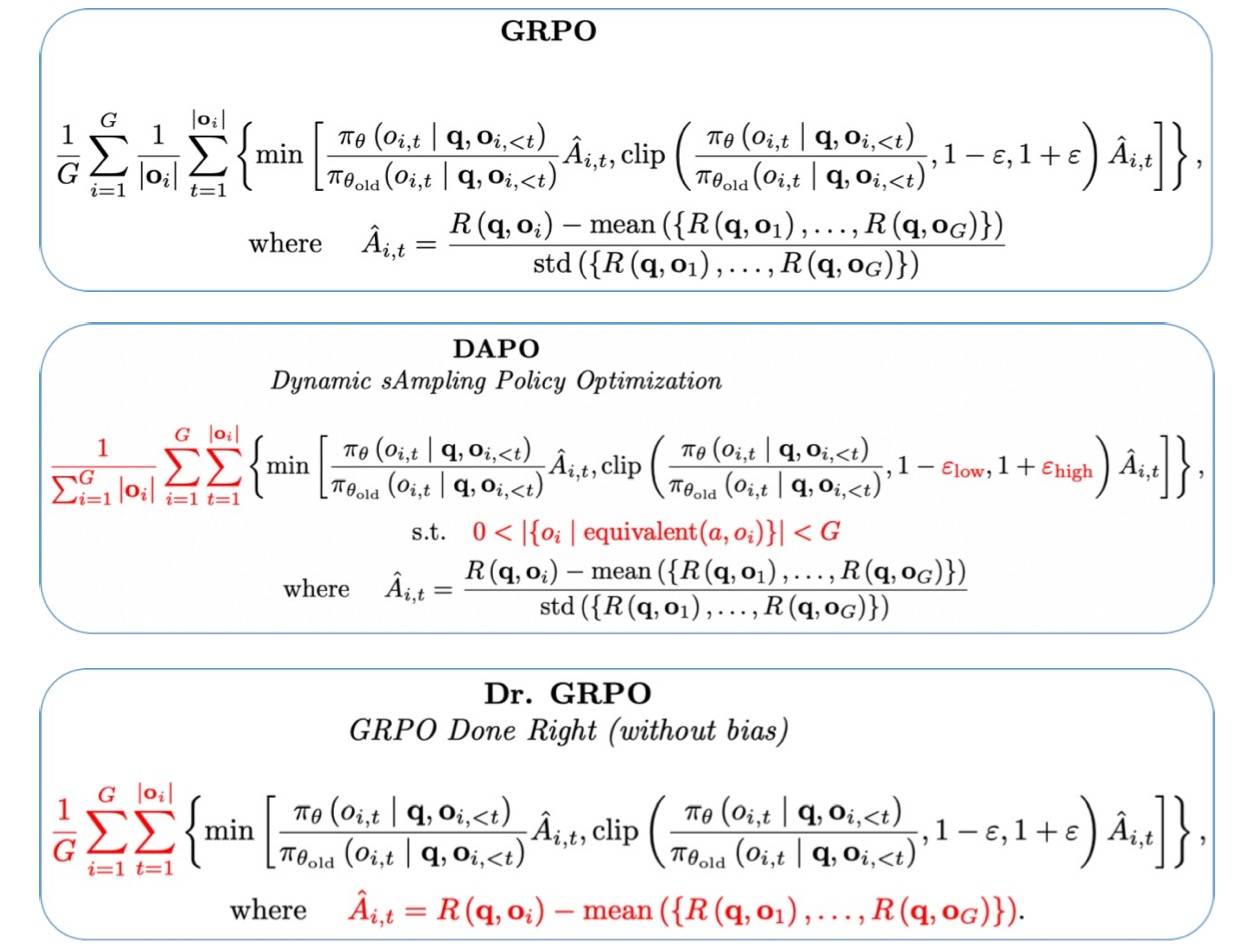
上一篇 GRPO“第一背锅侠”Token Level X:DAPO/DrGRPO与GSPO/GMPO的殊途同归 | Yam[1] 中,我们重点分析了 GSPO 和 GMPO 这两个非常相似的与 token 级别有关的优化算法,它们瞄准的是重要性比率。本文要介绍的 GTPO 和 GTPO(哈哈,两个撞名了)则是瞄准了 token 粒度有关的的梯度和优势/奖励,而且两者都重点关注了“熵”的作用。值得注意的是,虽然瞄准的是梯度和优势/奖励,但与OPO[2] 和 AAPO[3]、BNPO[4] 不同,关注到 token 粒度。
8号一大早出门团建,赶路过程中看到群里X哥来了句“5感觉有点难评”,H哥来了句“感觉有点失望”。X哥接着补充“我感觉o系列有点打乱openai本来的节奏,我理解本来5应该预想是全模态模型”。是的,没错,今天凌晨GPT-5发布,反响不一,但总体来看好像并没有达到大家的预期。至于大家的预期是什么,那肯定不一而足,不过就发布的内容来看——一个正常的LLM、一个推理模型和一个动态router,这显然是不能让绝大部分人满意的。
注意!注意!注意!本文观点一家之言,如有不当之处,恳请读者批评指正!
OpenAI终于开源了,无论如何,他们的一举一动总是会受人关注的。第一时间阅读了技术报告,乍一看好像没什么,而且好像有大量安全方面的内容。不过仔细阅读后,还是发现有一些不一样的细节。
周六下午出去日常“漫游”,地铁上看了数据标注公司Surge AI创始人Edwin Chen的访谈和Manus的上下文工程两篇文章,结合自己之前的一些思考,感觉很多东西又串联起来了,突然就想把它们写出来。晚上回来,从23点写到凌晨3点,终于搞定,是有此文。
好吧,准确来说,GiGPO[1](Group-in-Group Policy Optimization)还是GRPO,只不过它扩展到Agent范围。简单来说,就是把采样轨迹分成多个组,每个组当然对应关键步骤。稍微通用一点来看,其实是更加细粒度的GRPO。很自然地,有两个不同的级别:
上篇Reward Model建模 | Yam[1]我们介绍了Reward相关的建模方案,本文继续介绍几篇Reward数据相关的论文。
Reward 数据的价值远不止于监督信号本身。本文剖析的三项研究揭示:Skywork-Reward-V2 优化了人机协同的标注效率;Spurious Rewards 的核心发现表明,RL 训练(如 GRPO)的核心作用常在于“激活”而非“教授”——虚假奖励亦能激发基座模型预训练习得的优势推理策略(如代码推理);Anthropic ICM 则利用模型内部一致性实现无监督引导。这昭示着 Reward 建模的新方向:深刻理解基座模型的“潜能图谱”,并设计机制(协同标注、激活信号、一致性约束)将其高效释放,最终迈向规则驱动的“演绎式”智能。
偶尔看到这篇文章:如何不通过提示词或微调来引导大模型的输出 - 知乎[1],感觉很有意思,于是根据文章提供的代码做了一些实验,同时,也查阅了相关Paper,补充了一些实验和论文阅读,一并记录在此。